AI TOP ATOM frente a DGX Spark: qué diferencias hay ¿reales?
Una GIGABYTE AI TOP ATOM y un DGX Spark de NVIDIA se basan en el mismo chip GB10 y en los mismos 128 GB de memoria. Nuestras mediciones difieren como máximo un 4,3 % de las publicadas para el DGX Spark con llama.cpp, y un 2 % con Ollama. GIGABYTE aporta su propia carcasa, del mismo formato de un litro que la Founders Edition, su refrigeración y sus seis referencias. Durante 2 horas de carga continua, la velocidad se mantuvo estable, sin ninguna ralentización impuesta.
El DGX Spark de NVIDIA y la AI TOP ATOM de GIGABYTE se basan en el mismo chip GB10. ¿Qué cambia realmente? En nuestra AI TOP ATOM, proporcionada gratuitamente por GIGABYTE, repetimos tres series de mediciones publicadas para el DGX Spark; después medimos su comportamiento bajo carga durante 1 y 2 horas, sus temperaturas y su SSD, y comprobamos sus puertos. A continuación aparecen los precios por referencia y nuestros consejos de compra.
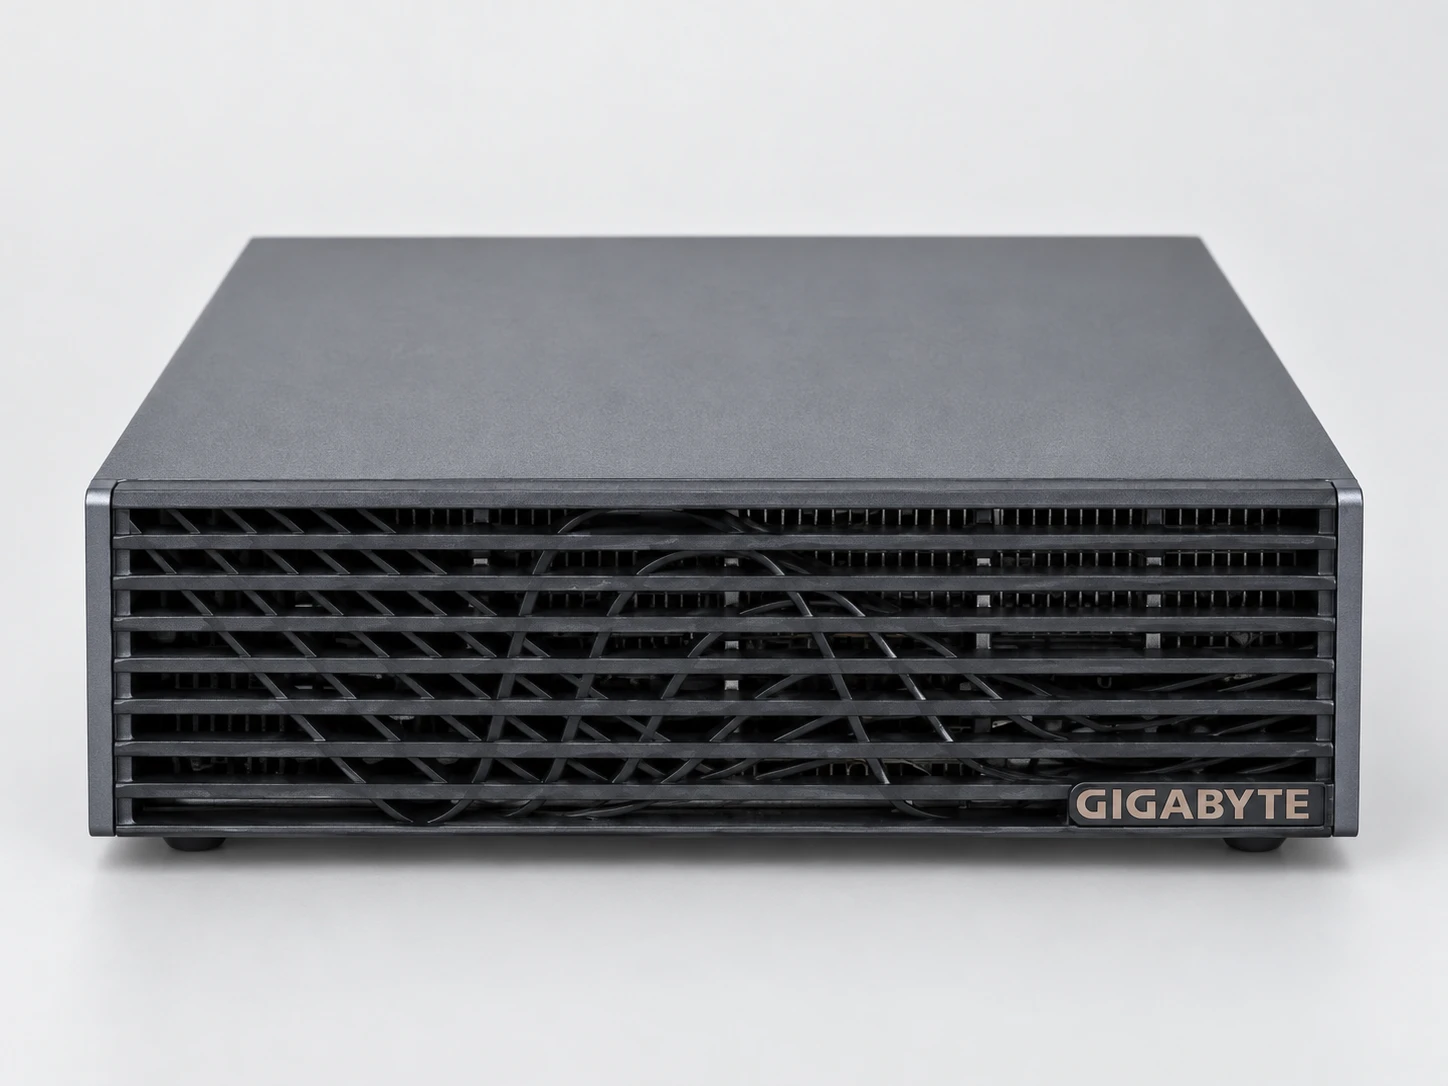
#Misma CPU NVIDIA GB10, fabricación de GIGABYTE
El DGX Spark es una plataforma de NVIDIA. Su chip GB10 reúne 20 núcleos Arm y una GPU de generación Blackwell, que comparten 128 GB de memoria anunciada a 273 GB/s. NVIDIA también proporciona el sistema DGX OS, el controlador y CUDA. El DGX Spark vendido por NVIDIA se llama Founders Edition. Otros fabricantes, entre ellos GIGABYTE, ofrecen su propia máquina sobre la misma base.
Esta separación organiza toda la guía. Lo que procede de NVIDIA se encuentra en todas las máquinas GB10: la sección siguiente lo comprueba mediante mediciones. Lo que procede de GIGABYTE se evalúa en el chasis, la refrigeración, el almacenamiento, las referencias y la garantía. StorageReview, un sitio estadounidense de pruebas de hardware, escribe que, como todas estas máquinas comparten la misma base GB10, la diferencia de rendimiento en IA sigue siendo estrecha.
| Elemento | Proporcionado por | En nuestro AI TOP ATOM |
|---|---|---|
| Chip GB10: 20 núcleos Arm, GPU Blackwell | NVIDIA | Velocidades a menos del 5 % de las publicadas (sección siguiente) |
| Memoria unificada de 128 GB, 273 GB/s | NVIDIA (plataforma) | El sistema ve 121,7 GB; una parte está reservada para el arranque |
| DGX OS, controlador, CUDA | NVIDIA | DGX OS 7.5.0, controlador 580.159.03, CUDA 13.0 |
| Formato de 150 × 150 × 50,5 mm y 1,2 kg | El mismo formato que la Founders Edition | Carcasa negra mate, frontal de lamas sin puerto ni botón |
| Refrigeración y acabado | GIGABYTE | Disipador, placas de cobre, tubos de calor y dos ventiladores, según ServeTheHome |
| SSD: capacidad y generación PCIe | GIGABYTE (según la referencia) | Samsung de 4 TB, PCIe 5.0 verificado (32 GT/s en 4 líneas) |
| Fuente de alimentación de 240 W por USB-C | GIGABYTE (adaptador incluido) | NVIDIA exige utilizar la fuente de alimentación incluida |
| Referencias, precios y garantía | GIGABYTE y distribuidores | Ver las secciones de referencias y precios |
#Las mismas velocidades que el DGX Spark: tres comprobaciones
Para comparar el ATOM con las referencias del DGX Spark, repetimos tres mediciones publicadas para esta máquina, con la misma herramienta. Para llama.cpp y Ollama, la versión y los ajustes también son los mismos; para vLLM, no se han publicado la versión ni el comando. Si nuestro ATOM obtiene las mismas cifras, ofrece el mismo rendimiento que la referencia.
#Método y unidades
Cada velocidad de llama.cpp es la media de 5 repeticiones, con una desviación estándar inferior al 3 % (la desviación estándar mide la dispersión de las repeticiones). La velocidad de lectura es aquella a la que la máquina absorbe tu texto antes de responder. La velocidad de escritura es la de la respuesta que se muestra.
Ambos se miden en tokens por segundo (tok/s); un token es un fragmento de palabra, aproximadamente dos tercios de una palabra en francés. Las memorias y las velocidades de disco están expresadas en GB y GB/s, como las muestra Linux: 1 GB = 1.024 MB.
El protocolo quedó fijado antes de la primera medición. Cada prueba añadida después se describe en una adenda fechada, redactada antes de la prueba. El método, la lista fechada de adendas y los datos de nuestras tablas se publican en nuestra página sobre el método.
#Con llama.cpp: con una diferencia de hasta el 4,3 %
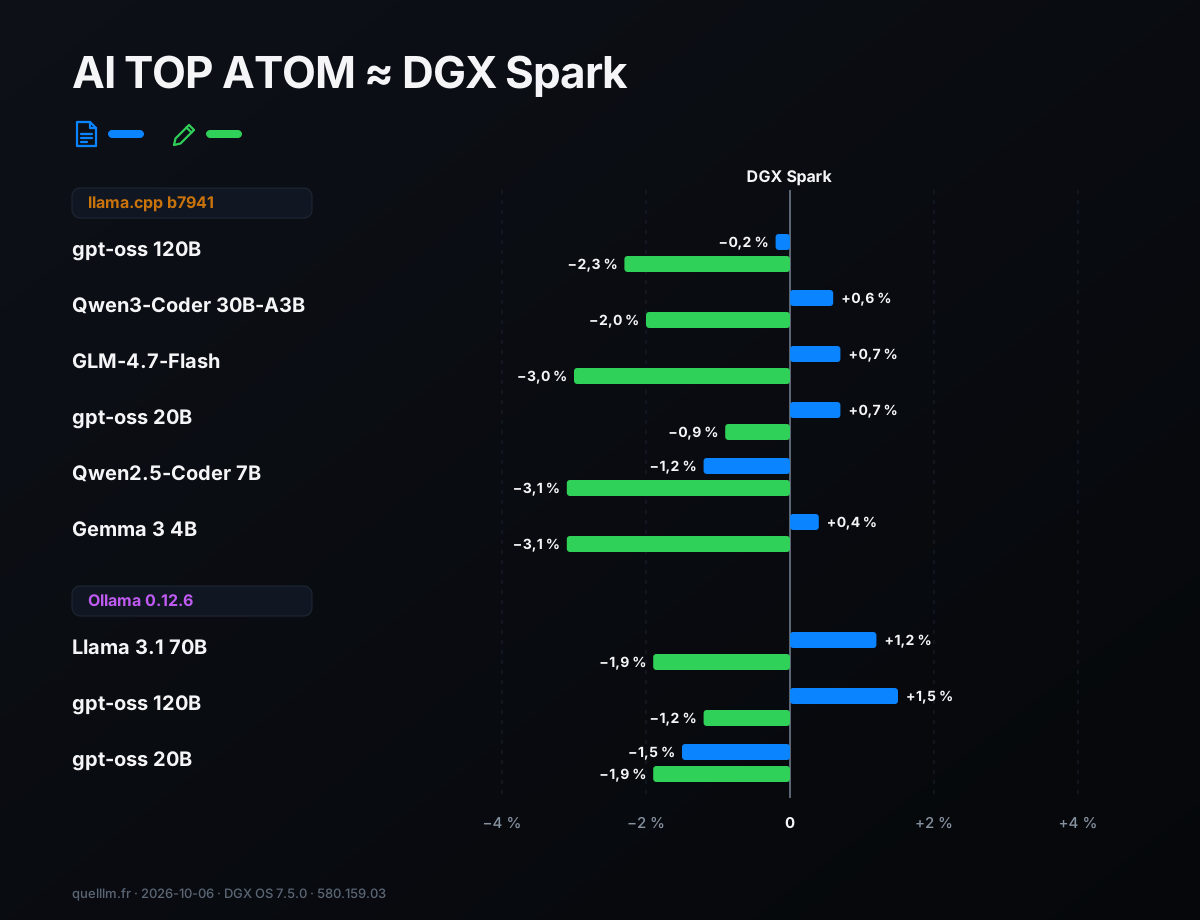
llama.cpp es un motor de código abierto muy extendido para ejecutar modelos localmente. El proyecto publica una tabla de referencia para el DGX Spark, con la compilación 7941 (es el número de versión del software), en febrero de 2026. Compilamos la misma versión y ejecutamos el mismo comando en seis modelos y cinco profundidades de contexto, es decir, 60 puntos de medición. El contexto es el texto que ya está presente en la memoria: de 0 a 32 768 tokens.
Resultado: la velocidad de lectura es idéntica con una diferencia de hasta el 2,3 %, y una diferencia mediana de +0,3 %. La velocidad de escritura se mantiene al mismo nivel, con una diferencia mediana de −2,8 % (4,3 % como máximo). Para gpt-oss 120B, la lectura con contexto vacío es igual a la referencia: 2 443,9 tok/s en ambos casos. La tabla de referencia corresponde a un controlador más antiguo (580.95.05) que el nuestro (580.159.03).
#Con el script oficial de Ollama: a un 2 % de distancia
Ollama publicó sus propias mediciones para el DGX Spark en octubre de 2025, con su versión 0.12.6 y el controlador 580.95.05. Utilizamos la misma versión y el mismo script, con 10 pasadas y una temperatura de 0. Los tres modelos publicados dan resultados con una diferencia de hasta el 2 %, tanto en lectura como en escritura.
| Modelo | Lectura: nosotros / publicado | Diferencia | Escritura: nosotros / publicado | Diferencia |
|---|---|---|---|---|
| gpt-oss 20B | 3 175,0 / 3 224 | −1,5 % | 57,18 / 58,27 | −1,9 % |
| gpt-oss 120B | 1 186,8 / 1 169 | +1,5 % | 40,65 / 41,14 | −1,2 % |
| Llama 3.1 70B | 1 933,6 / 1 911 | +1,2 % | 4,34 / 4,423 | −1,9 % |
#Con vLLM: el mismo orden de magnitud, un motor diferente
StorageReview midió el ATOM el 3 de marzo de 2026 con vLLM, un servidor diseñado para responder a varias personas a la vez, en gpt-oss 120B. StorageReview no publica ni la versión de vLLM ni el comando exacto. Repetimos sus tres escenarios con vLLM 26.09, para 1 y para 64 usuarios.
Nuestras velocidades son del mismo orden de magnitud que las suyas, por encima o por debajo según el escenario. Con un usuario, en el escenario en el que la máquina lee 4 096 tokens y escribe 512, obtenemos un total de 304,4 tokens por segundo, frente a los 304,6 de StorageReview.
Con 64 usuarios, en el escenario equilibrado (256 tokens leídos, 256 escritos), alcanzamos 695 tokens por segundo, frente a 650. Como la versión de vLLM no es la misma, presentamos estas cifras como del mismo orden de magnitud y no como una comparación de máquinas. Durante estas pruebas, no se interrumpió ninguna solicitud.
En resumen: con llama.cpp y Ollama, dos motores muy utilizados en local, el ATOM ofrece, con una diferencia inferior al 5 %, el mismo rendimiento que un DGX Spark. Para conocer la velocidad de cada modelo en este chip, consulte nuestra primera guía de la serie.
#Qué aporta GIGABYTE: chasis, refrigeración y referencias
La AI TOP ATOM mide 150 × 150 × 50,5 mm y pesa 1,2 kg, es decir, tiene un volumen de aproximadamente un litro: es el formato de la Founders Edition. La carcasa es de color negro mate. El frontal tiene lamas, con un patrón ondulado, y no lleva ningún puerto ni botón: todo se conecta en la parte trasera.
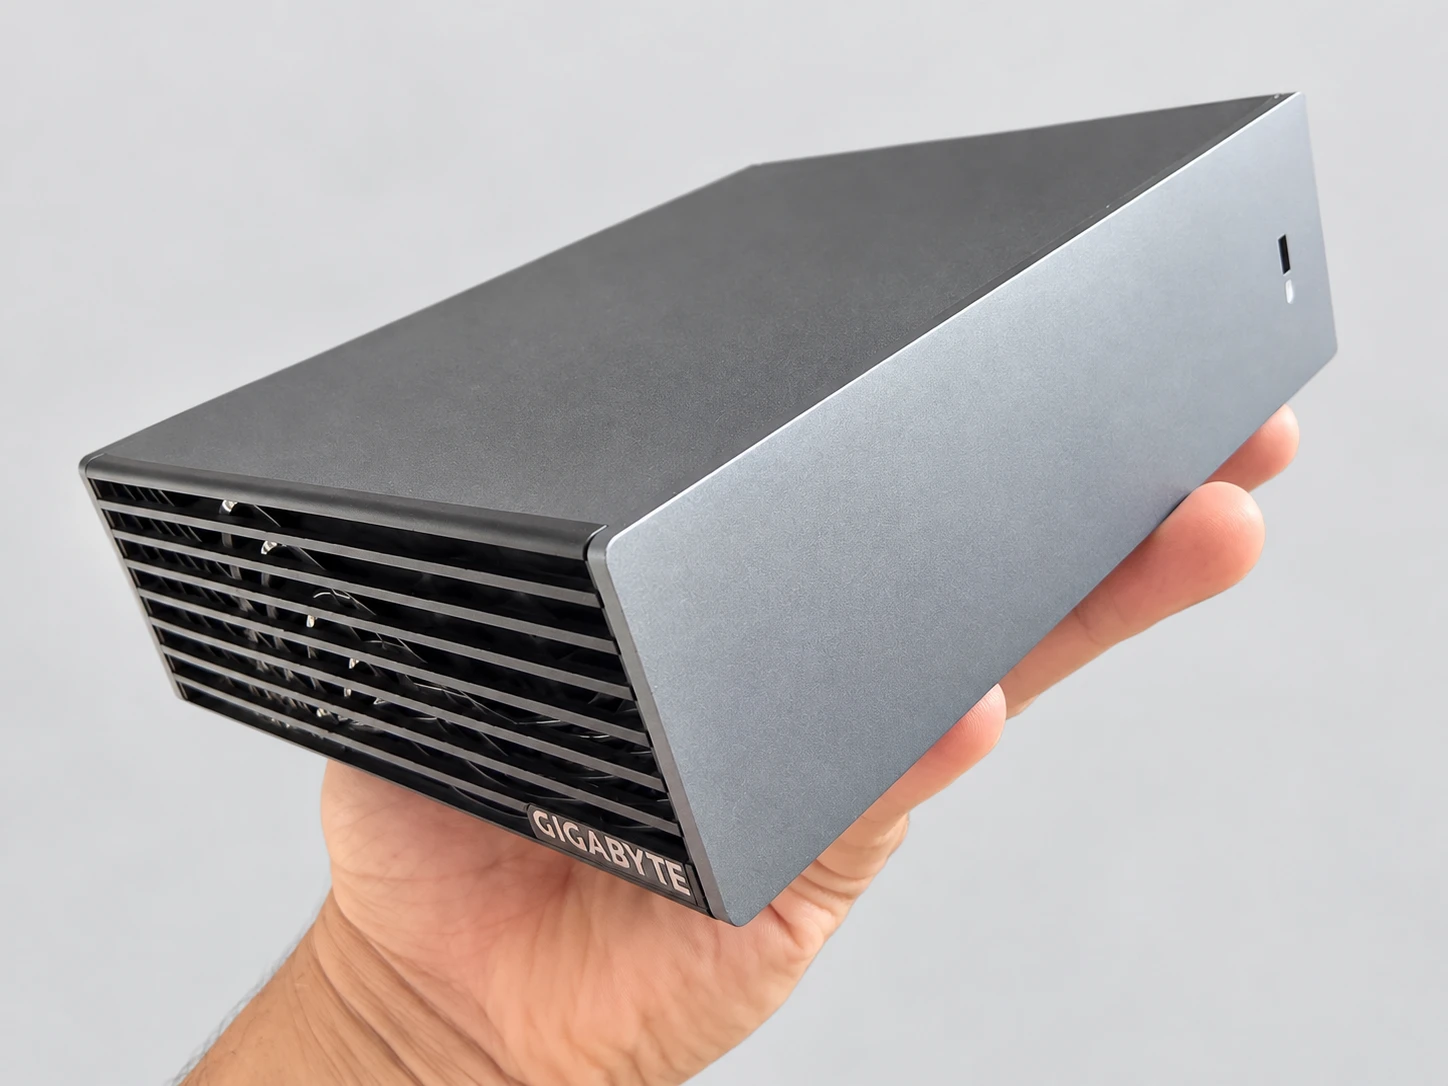
ServeTheHome abrió la máquina. Describe un disipador grande, con placas de cobre sobre los chips y tubos de calor, refrigerado por dos ventiladores Delta. StorageReview comparó cinco máquinas GB10 en enero de 2026. La GIGABYTE alcanza entre 87 y 88 °C como máximo durante los picos de carga, igual que la Founders Edition y la máquina Dell.
StorageReview la sitúa entre los mejores perfiles de refrigeración, con uno de los niveles de potencia de GPU más altos. Después de más de una hora de calentamiento, ServeTheHome encuentra el ATOM al nivel del DGX Spark de NVIDIA, con una ligera ventaja en varias de sus pruebas de IA.
Peter Falkingham, que utiliza una ATOM desde julio de 2026 para un laboratorio universitario, la describe en su prueba como casi silenciosa.
#Seis referencias, con un SSD a elegir
La página del producto de GIGABYTE enumera seis referencias, de ATAGB10-9000 a ATAGB10-9005. La tabla muestra las que hemos podido verificar.
| Referencia | Memoria | SSD |
|---|---|---|
| ATAGB10-9000 (nuestra unidad) | 128 GB | 4 TB en PCIe 5.0 |
| ATAGB10-9001 | 128 GB | 4 TB en PCIe 4.0 |
| ATAGB10-9002 | 128 GB | 1 TB en PCIe 4.0 |
| ATAGB10-9003 a 9005 | 128 GB o 64 GB | 2 TB o 1 TB en PCIe 4.0 (no verificado referencia por referencia) |
En la 9000, el SSD es un Samsung de la familia PM9E1, el mismo modelo que el de la Founders Edition según StorageReview. Es un módulo M.2 2242. Según ServeTheHome, es el único componente que el usuario puede sustituir.
#Alimentación, caja y garantía
El adaptador de 240 W se conecta al puerto USB-C reservado para la alimentación. NVIDIA exige utilizar la fuente de alimentación suministrada para obtener un rendimiento óptimo. La caja contiene la máquina, el adaptador y el cable de alimentación. GIGABYTE vende por separado un cable QSFP para conectar dos máquinas: 94,04 € con IVA en la tienda oficial de AORUS (precio comprobado el 8 de octubre de 2026).
En cuanto a la garantía, el manual de GIGABYTE indica que la duración se especifica en el sitio del producto o en su etiqueta. LDLC anuncia 5 años de garantía para la 9000 (registrado el 8 de octubre de 2026). Lea la duración en la ficha del distribuidor antes de comprar.
#Puertos y conectividad
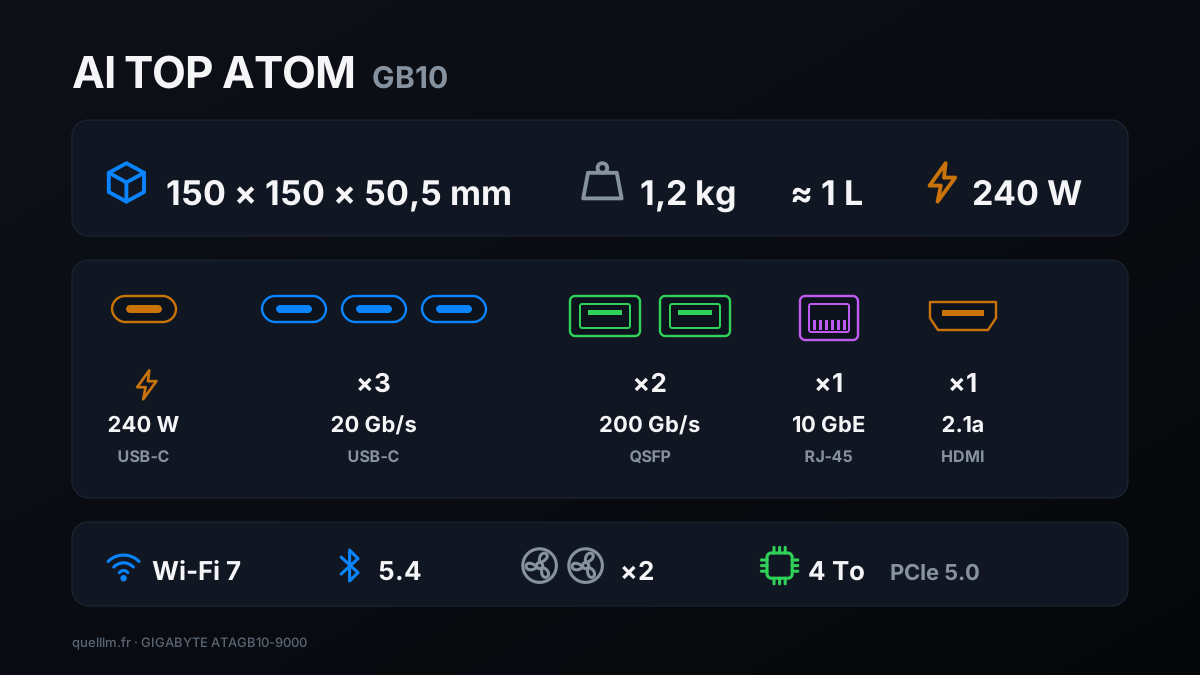
La lista reproduce la ficha de GIGABYTE, y la ficha de NVIDIA para la Founders Edition indica los mismos puertos. En nuestra unidad, comprobamos la red cableada y el enlace del SSD, e identificamos el módulo Wi-Fi.
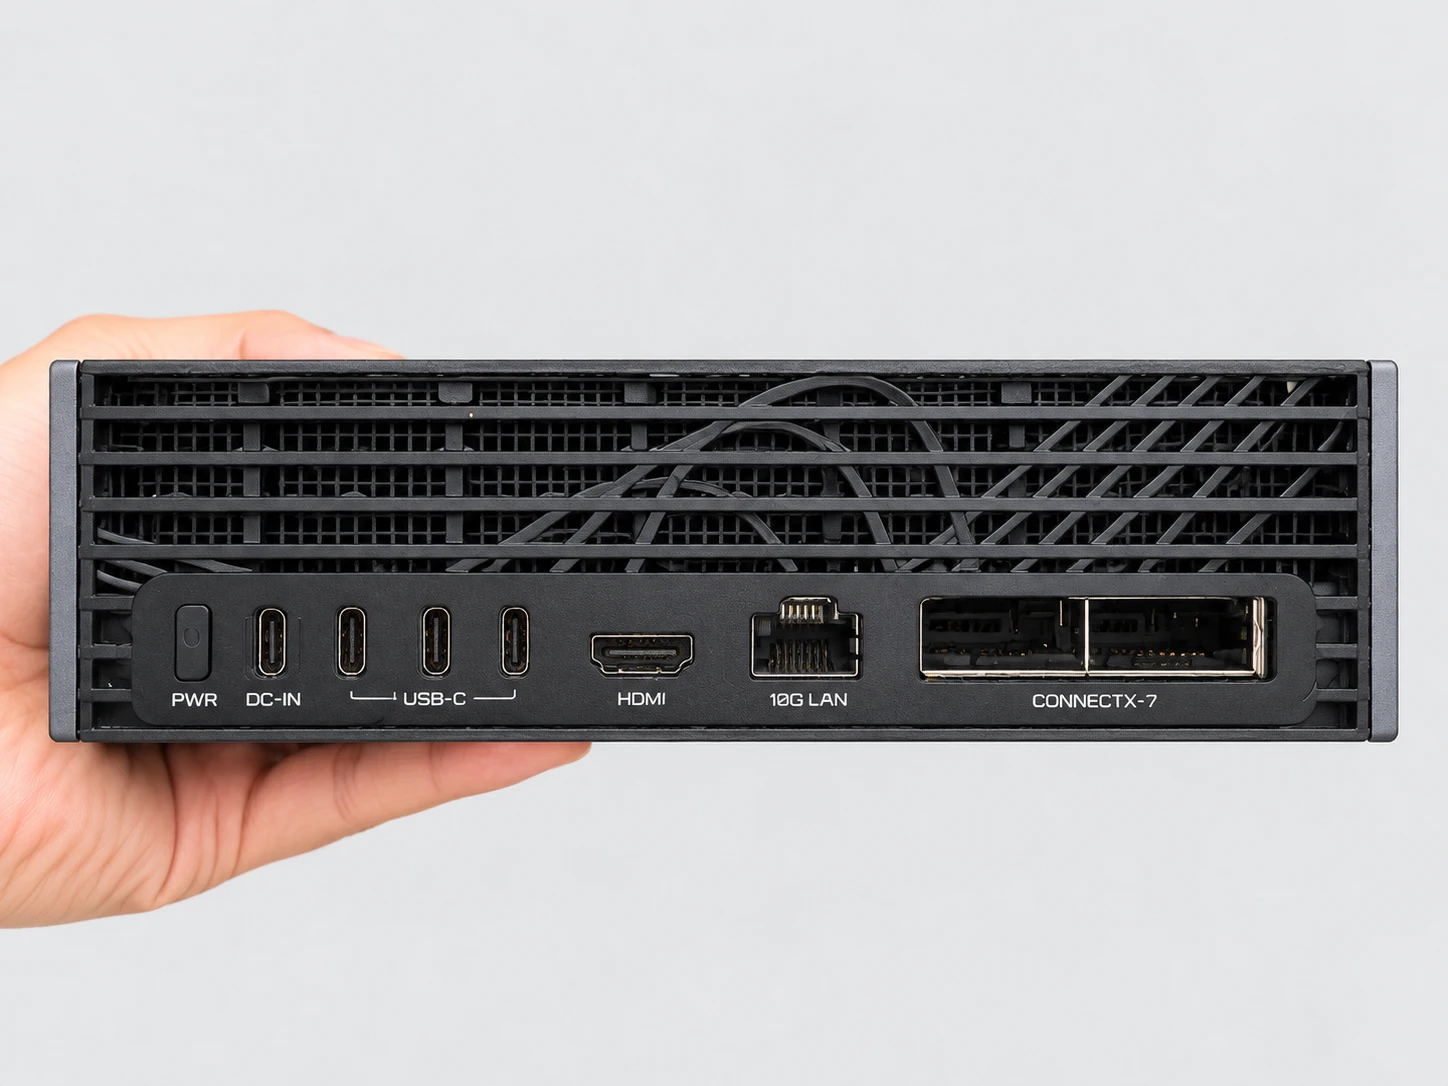
- Alimentación
- Un puerto USB-C reservado para la alimentación, con el adaptador de 240 W incluido.
- USB
- Tres puertos USB-C a 20 Gb/s (USB 3.2 Gen 2x2) para discos y accesorios.
- Red cableada
- Un conector RJ-45 de 10 GbE. En nuestra unidad, el enlace negociado es de 10 Gb/s.
- Red de alta velocidad
- Dos puertos QSFP (tarjeta NVIDIA ConnectX-7, 200 Gb/s) para conectar varias máquinas. No probamos este enlace.
- Vídeo
- Una salida HDMI 2.1a, con audio multicanal.
- Inalámbrico
- Wi‑Fi 7 y Bluetooth 5.4. Nuestro sistema identifica un chip MediaTek MT7925.
#Rendimiento bajo carga: 1 hora y 2 horas seguidas
Una máquina compacta debe soportar la carga sin ralentizarse. Una ralentización impuesta por el calor o por el límite de potencia se denomina estrangulamiento. Hicimos trabajar la ATOM sin pausa con vLLM 26.09. Cada sesión se divide en tramos: un tramo es un lote de solicitudes enviado justo después del anterior. Durante ese tiempo, registramos cada segundo la frecuencia del GPU, su potencia, su temperatura y los motivos de estrangulamiento declarados por el controlador.
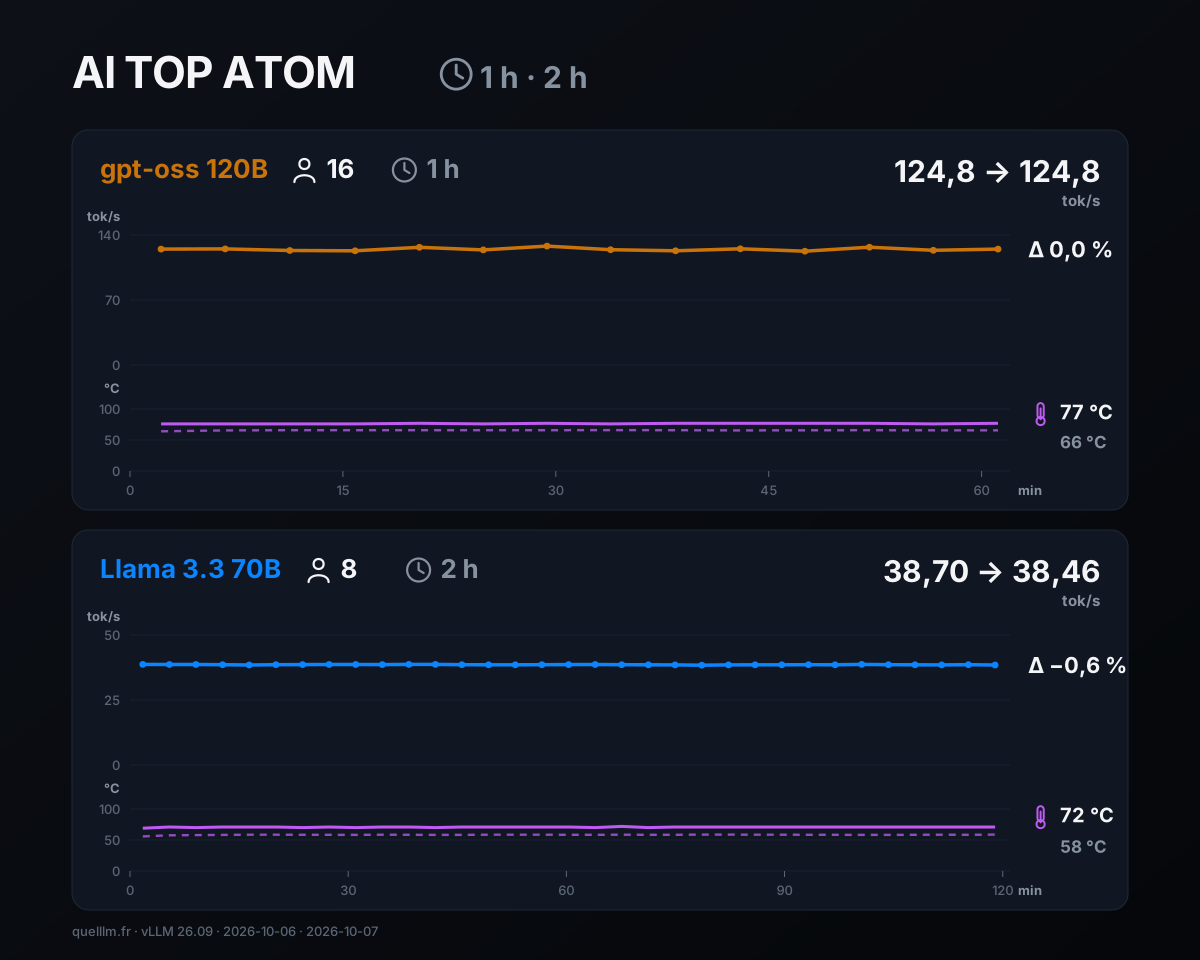
| Sesión | Solicitudes | Rendimiento: primera → última franja | Deriva | Temperatura de la GPU | Bridage |
|---|---|---|---|---|---|
| 1 h, gpt-oss 120B, 16 usuarios, 14 tramos | 896, ningún fallo | 124,8 → 124,8 (de 122,6 a 128,1) | 0,0 % | 77 °C / 66 °C | Ninguno |
| 2 h, Llama 3.3 70B NVFP4, 8 usuarios, 33 tramos | 1 056, ningún fallo | 38,70 → 38,46 (de 38,40 a 38,70) | −0,6 % | 72 °C / 58 °C | Ninguno |
Durante una hora, 16 usuarios enviaron continuamente solicitudes de 4 096 tokens, con respuestas de 512 tokens. Los 14 tramos de 64 solicitudes dieron un rendimiento casi idéntico, de 122,6 a 128,1 tok/s en total, y tanto el primero como el último alcanzaron 124,8 tok/s. Cada persona veía escribirse su respuesta a unos 8 tok/s. El reloj de la GPU tuvo una mediana de 2 509 MHz durante esta sesión.
Durante dos horas, 8 usuarios trabajaron con Llama 3.3 70B en formato NVFP4, un formato comprimido de NVIDIA, con 1 024 tokens leídos y 256 escritos por solicitud. El rendimiento total se mantuvo entre 38,40 y 38,70 tok/s en 33 tramos de 32 solicitudes.
La deriva es de −0,6 % entre el primer y el último tramo, y de −0,2 % al comparar las medianas de los cinco primeros y los cinco últimos. Cada persona veía escribirse su respuesta a unos 5,1 tok/s, y la primera palabra llegaba en 2,8 s (mediana). El reloj de la GPU tuvo una mediana de 2 528 MHz.
El controlador no declaró ningún motivo de limitación durante las dos sesiones: el valor registrado se mantuvo en cero, segundo tras segundo. La GPU alcanzó como máximo 77 °C con 16 usuarios y 72 °C con 8 usuarios. La zona más caliente de los sensores del sistema alcanzó 87 °C durante la primera sesión y 80 °C durante la segunda.
Durante la segunda, el SSD alcanzó un máximo de 49 °C. El firmware no da nombre a estas zonas: no las atribuimos al procesador. Como comparación, StorageReview registró un máximo de 87 a 88 °C en el pico de carga en la Founders Edition, la máquina Dell y la GIGABYTE.
#En reposo
Tras 20 minutos en calma, registramos la máquina durante 30 minutos. La GPU consume una media de 10,4 W (de 10,2 a 11,0 W) y se mantiene entre 35 y 36 °C. La zona más caliente de los sensores del sistema alcanza como máximo 46 °C, y el SSD se mantiene entre 34 y 35 °C. No se declaró ningún motivo de limitación.
La potencia indicada es la de la GPU, comunicada por sus sensores; no representa el consumo total de la máquina. No se registró la temperatura ambiente. La sesión de una hora tuvo lugar a primera hora de la tarde y la de 2 horas, por la noche, cuando probablemente la habitación estaba más fresca.
#El SSD: 13 GB/s de lectura, 1,28 millones de IOPS
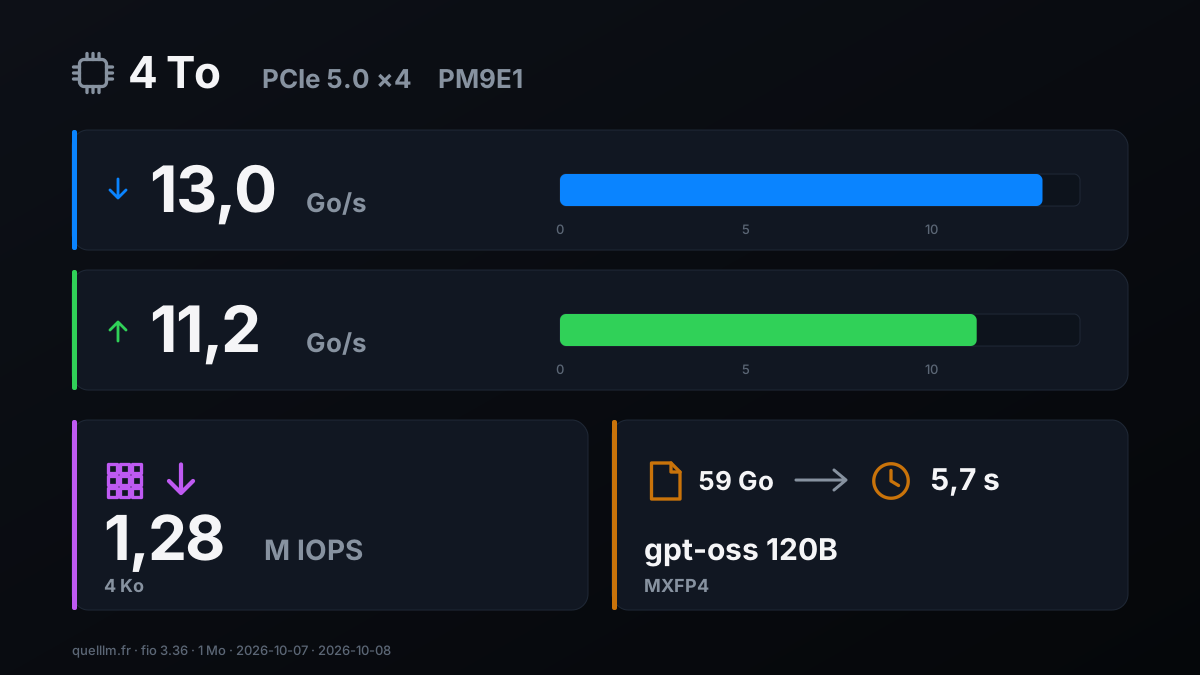
La referencia 9000 incorpora un SSD Samsung MZALC4T0HBL1 de 4 TB, de la familia PM9E1. El sistema confirma un enlace PCIe 5.0: 32 GT/s en 4 líneas. PCIe es la conexión entre el SSD y el chip; la versión 5.0 va el doble de rápido que la 4.0.
Lo medimos con fio 3.36, en un archivo de 64 GB escrito por completo antes de la lectura, mediante acceso directo, es decir, sin pasar por la caché del sistema. Los IOPS son el número de operaciones de lectura o escritura por segundo.
| Test | Resultado |
|---|---|
| Lectura secuencial, bloques de 1 MB, 1 tarea | 13,0 GB/s (12,99 con io_uring, 13,37 con libaio, dos métodos de acceso al disco de Linux) |
| Lectura aleatoria, bloques de 4 KB, 4 tareas | 1,28 millones de IOPS con io_uring, 1,19 millones con libaio (aproximadamente 4,9 GB/s con io_uring) |
| Escritura secuencial en ráfaga, bloques de 1 MB, archivo nuevo de 32 GB, disco en reposo | 11,2 GB/s |
| Lectura del archivo de gpt-oss 120B (59 GB) | 5,7 s |
StorageReview publicó, con otra herramienta (gdsio) y el mismo modelo de SSD, entre 11,0 y 11,6 GB/s de lectura y 12,2 GB/s de escritura. Nuestros valores son del mismo orden de magnitud, con una lectura ligeramente superior. En la práctica, un modelo grande se carga en unos segundos: el archivo de gpt-oss 120B, de 59 GB, se leyó en 5,7 s.
En la 9000 encontrarás el SSD de 4 TB de la Founders Edition: es el mismo modelo, por lo que no distingue el ATOM de la referencia NVIDIA. La diferencia existe entre las referencias de GIGABYTE: la 9000 tiene un SSD en PCIe 5.0, y la 9001 y la 9002, en PCIe 4.0. Las mediciones del SSD corresponden a la referencia 9000.
#¿64 o 128 GB?
El 2 de octubre de 2026, NVIDIA anunció un DGX Spark de 64 GB para modelos de hasta 100 mil millones de parámetros, disponible el 23 de octubre en Acer, ASUS, Dell, GIGABYTE, HP y MSI, desde 4 999 dólares. GIGABYTE confirmó el 5 de octubre una AI TOP ATOM de 64 GB con el mismo diseño. La disponibilidad en Francia no está confirmada a día de hoy. No la hemos medido.
Nuestras mediciones de la primera guía de la serie permiten hacer un cálculo. Los modelos de hasta Qwen3-Coder 30B-A3B ocupan menos de 35 GB con 32 768 tokens de contexto y cabrían en 64 GB. Llama 3.3 70B (51 GB) estaría en el límite. gpt-oss 120B (62 GB) y los modelos más grandes no cabrían. Con el mismo ancho de banda, algo que habrá que verificar, las velocidades deberían ser parecidas.
Para ejecutar un modelo de más de 100 000 millones de parámetros en una sola máquina, es necesaria la versión de 128 GB. Las seis referencias de la página de GIGABYTE permiten elegir la memoria y el SSD.
#Precio por referencia (precios registrados el 8 de octubre de 2026)
Los precios de GB10 cambian cada semana: compruébelos antes de comprar. Esto es lo que registramos el 8 de octubre de 2026 en Francia, con IVA incluido. Compare siempre la misma referencia: la 9001 (PCIe 4.0) y la 9000 (PCIe 5.0) no son la misma máquina.
| Marchand | Referencia | Precio con IVA | Disponibilidad indicada |
|---|---|---|---|
| Tienda oficial de AORUS | 9001 (4 TB en PCIe 4.0) | 6 346,27 € | Agotada |
| Amazon.fr, vendido por Amazon UK | 9001 (4 TB en PCIe 4.0) | Precio variable; consultar en Amazon.fr | 1 unidad |
| LDLC | 9000 (4 TB en PCIe 5.0) | 7 999,95 € | Rupture |
| Rue du Commerce, vendedores externos | 9000 (4 TB en PCIe 5.0) | Desde 7 999,95 € (3 ofertas) | Según el vendedor |
| Senetic.fr | 9000 (4 TB en PCIe 5.0) | 9 022,08 € | 5 unidades |
Materiel.net mostraba el mismo precio que LDLC para la 9000, también agotada. Como comparación, ese mismo día la MSI EdgeXpert, otra máquina GB10, aparecía a 6 599,95 € en Materiel.net, también agotada; la DGX Spark de PNY ya no se ofrecía allí ni en LDLC. Un precio mostrado para una máquina no disponible no es un precio de compra: compruebe también la disponibilidad.
#Lo que no hemos medido
- La comparación con el DGX Spark
- La comparación se basa en las mediciones publicadas para el DGX Spark, repetidas en el ATOM con las versiones de software indicadas.
- El ruido
- La valoración del ruido citada en esta página procede de la prueba de Peter Falkingham.
- El consumo de la máquina completa
- Las potencias de esta página corresponden únicamente a la GPU. Una próxima guía de la serie detallará el consumo.
- La temperatura de la habitación
- Las temperaturas publicadas proceden de los sensores integrados en la máquina.
- La conexión entre dos máquinas
- Los dos puertos QSFP (200 Gb/s) no se probaron.
- Las demás referencias y la versión de 64 GB
- Las mediciones corresponden a la referencia ATAGB10-9000 de 128 GB.
Esta página se actualizará si una nueva versión de DGX OS, del firmware o de nuestras herramientas cambia estos resultados; cada corrección llevará fecha.
#Para quién es la AI TOP ATOM la opción adecuada
Lo que sigue procede de nuestras mediciones de la referencia 9000 y de nuestros registros de precios del 8 de octubre de 2026.
- Quiere el rendimiento de referencia del GB10 en una carcasa cuidada
- La 9000 ofrece, como máximo con un margen del 4,3 %, las velocidades publicadas para el DGX Spark, con un SSD de 4 TB en PCIe 5.0 medido a 13 GB/s en lectura.
- … mantienes la máquina en tu escritorio
- Cabe en un litro, pesa 1,2 kg y tiene un frontal despejado. En reposo, la GPU consume aproximadamente 10 W.
- … atiendes a un equipo o a agentes de IA
- Una hora con 16 usuarios en gpt-oss 120B, seguida de dos horas con 8 usuarios en Llama 3.3 70B: la velocidad se mantuvo estable (deriva del 0,0 % y del −0,6 %), sin ningún estrangulamiento.
- … quieres pagar menos sin cambiar de chip
- La 9001, con un SSD de 4 TB en PCIe 4.0, aparecía a 6 346,27 € en la tienda oficial de AORUS el 8 de octubre de 2026, agotada, y disponible en Amazon.fr. Tiene el mismo chip y los mismos 128 GB; los registros de esta página corresponden a la referencia 9000.
- … tus modelos ocupan menos de 35 GB con su contexto
- La versión de 64 GB, anunciada para el 23 de octubre de 2026, debería ser suficiente (cálculo extraído de nuestra primera guía, no medido en esta versión). Espere a que esté disponible y a conocer su precio.
- … quieres conectar varias máquinas
- Los dos puertos QSFP (200 Gb/s) están previstos para este uso. GIGABYTE vende el cable por separado.
#FAQ
¿La AI TOP ATOM es tan rápida como un DGX Spark de NVIDIA?+
¿Qué cambia concretamente entre una ATOM y una Founders Edition?+
¿La AI TOP ATOM se ralentiza cuando trabaja durante mucho tiempo?+
¿Qué referencia elegir: 9000, 9001 o 9002?+
¿Hay que esperar a la versión de 64 GB?+
¿Un comentario, un error, una precisión? Avísanos, eso mejora la guía para todos.