GIGABYTE AI TOP ATOM: la GB10 de 128 GB medida en detalle
El mini-PC de IA de GIGABYTE: chip NVIDIA GB10 y 128 GB de memoria unificada en un litro. Analizamos lo que importa para ejecutar LLM en local : memoria, ancho de banda, velocidad, precio — y para quién es (o no) la compra adecuada.
Actualizado el 09/10/2026
Dónde comprarlo
La configuración indicada en el botón es la que se ofrece al comprar. En un mini-PC, reserva memoria para el sistema y comprueba el motor de inferencia; macOS/MLX y CUDA no son intercambiables.
Enlaces de afiliados — QuelLLM puede recibir una comisión por las compras, sin coste adicional para ti, lo cual no influye en estas recomendaciones (establecidas de forma independiente). Como socio de Amazon, QuelLLM obtiene ingresos por las compras que cumplan los requisitos.
Ficha técnica
- Memoria128 GB unificados (LPDDR5x), 121,7 GB visibles para el sistema
- Ancho de banda273 GB/s
- CálculoGPU Blackwell y 20 núcleos Arm; hasta 1 PFLOP en FP4 con dispersidad según NVIDIA (anuncio, no medido por nosotros)
- ConsumoAdaptador USB-C de 240 W; GPU a 10,4 W en reposo y de 39 a 53 W de media bajo carga según nuestras mediciones (solo GPU, sin vatímetro)
- Precio orientativo6 346,27 € (ATAGB10-9001, 4 TB PCIe 4.0, tienda oficial de AORUS, agotada; disponible en Amazon.fr) · 7 999,95 € (ATAGB10-9000, 4 TB PCIe 5.0, LDLC y Materiel.net, agotado) — registrado el 08/10/2026
- Modelo más grandeQwen3-235B-A22B en 3 bits (90,5 GB ocupados, 21 GB de margen) · Llama 3.3 70B a aproximadamente 5 tokens por segundo, entre 2,6 y 4 veces más rápido con un modelo borrador pequeño · gpt-oss 120B a 58 tokens por segundo; nuestros 13 modelos, del 4B al 235B, caben con 32 768 tokens de contexto
¿Para quién?
Ventajas y limitaciones
✓ Puntos fuertes
- 128 GB de memoria unificada: nuestros 13 modelos, del 4B al 235B (en 3 bits), caben con un contexto de 32 768 tokens
- Las velocidades de la DGX Spark de NVIDIA, con una desviación máxima del 4,3 % con llama.cpp y del 2 % con Ollama
- Velocidad estable bajo carga continua: 0,0 % de variación en 1 h con 16 usuarios, −0,6 % en 2 h con 8 usuarios, sin estrangulamiento registrado
- SSD de 4 TB PCIe 5.0 en el ATAGB10-9000: 13 GB/s de lectura
- Pila CUDA completa: llama.cpp, vLLM, TensorRT-LLM y Unsloth funcionaron en nuestras pruebas
- Chasis de un litro, 1,2 kg, frontal depurado
✗ Limitaciones
- Precio superior al de un mini-PC Ryzen AI Max+ 395 de 128 GB
- Un modelo denso de 70B escribe a aproximadamente 5 tokens por segundo, límite del ancho de banda de la plataforma GB10 (273 GB/s): un modelo MoE o un borrador pequeño (×2,6 a ×4) ofrece velocidades de conversación
Lo que hemos medido
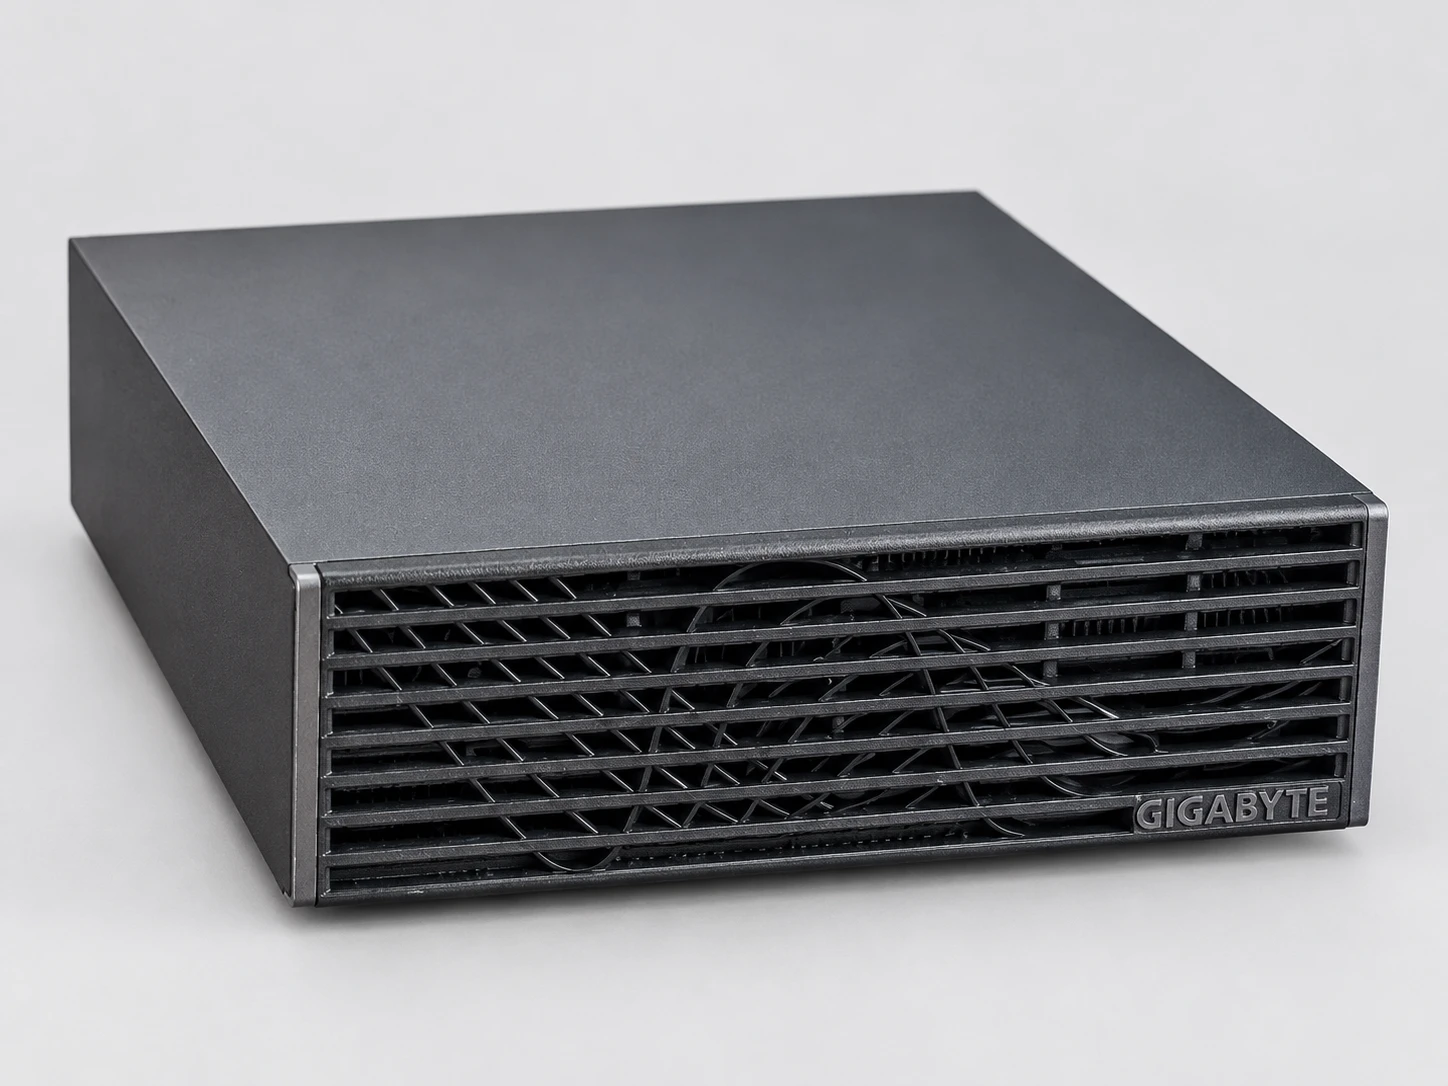
GIGABYTE nos proporcionó gratuitamente una AI TOP ATOM (ATAGB10-9000: 128 GB, SSD de 4 TB PCIe 5.0) para una serie de guías. Las mediciones y las opiniones son nuestras; GIGABYTE no revisó ni validó este contenido antes de su publicación. La metodología (protocolo fijado antes de la primera medición), las huellas de los archivos de los modelos y los datos de nuestras tablas se publican en nuestra página de metodología. Nuestros datos, infografías y fotos se pueden reutilizar bajo licencia CC BY 4.0, citando quelllm.fr.
| Guide | Lo que muestra |
|---|---|
| Qué LLM funcionan realmente | 13 modelos del 4B al 235B: todos caben con 32 768 tokens de contexto; gpt-oss 120B a 58 tokens por segundo |
La serie consta de 7 guías, publicadas una por semana: esta página se amplía con cada nueva guía.
Las referencias de AI TOP ATOM
GIGABYTE ofrece la ATOM en seis referencias, de ATAGB10-9000 a ATAGB10-9005. Las tres primeras tienen 128 GB: 9000 con un SSD de 4 TB en PCIe 5.0 (la que medimos), 9001 con 4 TB en PCIe 4.0, 9002 con 1 TB en PCIe 4.0. Se anuncia una versión de 64 GB a partir del 23 de octubre de 2026. Comprueba la referencia exacta en el distribuidor: algunas fichas describen mal el SSD.
Para quién
- Un equipo de 5 a 20 personas que quiere un asistente de IA privado para sus documentos (medido hasta 10 usuarios simultáneos).
- Un desarrollador de CUDA que quiere la pila NVIDIA completa sobre su escritorio.
- El fine-tuning local : LoRA de un Qwen3-8B, QLoRA de un 70B y de gpt-oss 120B con Unsloth.
- Los grandes modelos MoE de más de 100 mil millones de parámetros, a una velocidad cómoda.
Veredicto
Preguntas frecuentes
¿Puede el GIGABYTE AI TOP ATOM ejecutar un LLM 70B localmente?
Qwen3-235B-A22B en 3 bits (90,5 GB ocupados, 21 GB de margen) · Llama 3.3 70B a aproximadamente 5 tokens por segundo, entre 2,6 y 4 veces más rápido con un modelo borrador pequeño · gpt-oss 120B a 58 tokens por segundo; nuestros 13 modelos, del 4B al 235B, caben con 32 768 tokens de contexto.
¿Cuánto cuesta el GIGABYTE AI TOP ATOM?
Hay que contar con 6 346,27 € (ATAGB10-9001, 4 TB PCIe 4.0, tienda oficial de AORUS, agotada; disponible en Amazon.fr) · 7 999,95 € (ATAGB10-9000, 4 TB PCIe 5.0, LDLC y Materiel.net, agotado) — datos del 08/10/2026 (Versión de 64 GB anunciada por NVIDIA a partir de 4 999 $ (Estados Unidos), disponible desde el 23/10/2026; GIGABYTE confirmó una AI TOP ATOM de 64 GB el 05/10/2026). Los precios varían rápido — comprueba el precio del día mediante los enlaces de compra.
¿Para quién está hecha la GIGABYTE AI TOP ATOM?
Desarrolladores de CUDA, equipos que quieren un asistente de IA privado, ajuste fino local y grandes modelos MoE de más de 100B.