Asistente de IA privado para pymes en GB10: mesures
En una GIGABYTE AI TOP ATOM (chip NVIDIA GB10, 128 GB), una pila de software completa (la interfaz Open WebUI, el modelo gpt-oss 120B y el modelo de búsqueda bge-m3) arranca en 66 segundos y ocupa 68 GB. Indexa 5 000 páginas en 6 minutos, encuentra el documento correcto en el 86 % de los casos con 500 páginas (78 % con 5 000) y responde en 10 segundos a una persona. Durante 200 respuestas, ningún contenedor envió paquetes al exterior. Cada respuesta cuesta 0,15 Wh de GPU.
Una pyme que quiere consultar sus contratos y procedimientos con una IA enseguida se plantea una pregunta: ¿adónde van mis documentos? Un asistente privado lo guarda todo en una máquina de la oficina. Se basa en RAG (generación aumentada por recuperación): el sistema busca primero los fragmentos útiles en tus archivos y después un modelo redacta la respuesta. Medimos una pila completa en un AI TOP ATOM cedido gratuitamente por GIGABYTE, con los documentos de una empresa ficticia.
#Qué contiene la pila: tres programas, 68 GB
Un asistente privado se compone de tres bloques, que instalamos en contenedores Docker en una AI TOP ATOM (referencia ATAGB10-9000, DGX OS 7.5.0). Los modelos se ejecutan con llama.cpp, build 11430.
- Open WebUI 0.11.4
- La interfaz web: cuentas, importación de archivos, bases de conocimiento y conversación. También es la que divide los documentos en fragmentos, de 1000 caracteres con 100 de solapamiento por defecto, y la que conserva los 5 fragmentos más cercanos a cada pregunta.
- gpt-oss 120B (MXFP4)
- El modelo que redacta la respuesta, servido por llama-server (el servidor incluido con llama.cpp). MXFP4 es su formato original, ya comprimido. Está configurado para 10 solicitudes en paralelo. Es un modelo MoE (mezcla de expertos): en cada token, solo usa 5,1 de sus 117 mil millones de parámetros.
- bge-m3 (Q8_0)
- El modelo de embeddings, usado aquí en versión Q8_0 (compresión a 8 bits). Transforma cada fragmento en una secuencia de números que representa su significado, lo que permite comparar una pregunta con los fragmentos. Es multilingüe, por lo que sirve para el francés.
El arranque completo, con la caché de disco vaciada, tardó 66 segundos hasta tener una interfaz lista. La pila ocupa 68,0 GB de memoria: el proceso gpt-oss 120B ocupa 63,6 GB en la GPU y bge-m3, 0,8 GB; el resto corresponde a Open WebUI y al sistema.
Tras el arranque, quedan 48,6 GB disponibles en la máquina. Las memorias de esta guía están en GB, tal como las muestra Linux: 1 GB = 1 024 MB. Nuestra primera guía de la serie detalla la velocidad de gpt-oss 120B: 58 tokens por segundo.
#La empresa ficticia y las 100 preguntas
Aprovecha nuestra experiencia y un recorrido guiado para construir tu RAG local y trabajar con tus propios documentos.
- Espacio en línea de por vida
- PDF + archivos
- Reembolsado 30 d
Lustrelle es una pyme ficticia que inventamos: un taller, un almacén, un servicio posventa y unas oficinas. Sus 60 documentos son archivos de texto en formato Markdown (un texto sencillo con algunos signos para los títulos y las listas). Tratan sobre recursos humanos, la seguridad del taller, las copias de seguridad, las notas de gastos, las devoluciones de clientes o el plan de formación. Contienen cifras, nombres y condiciones precisos, para que cada respuesta pueda verificarse.
Para alcanzar volúmenes realistas, añadimos fichas públicas de Service-Public, tal como prevé nuestro protocolo. Así se obtienen tres bases de tamaño creciente. Los detalles metodológicos de esta guía se fijan en una adenda a nuestro protocolo, fechada el 7 de octubre de 2026, antes de la primera respuesta del asistente. El protocolo quedó fijado antes de la primera medición; el método, la lista fechada de adendas y los datos de nuestras tablas están publicados en nuestra página de metodología.
| Base | Archivos | Contenido |
|---|---|---|
| 50 páginas | 26 | 26 de los 60 documentos de Lustrelle |
| 500 páginas | 114 | los 60 documentos de Lustrelle y 54 fichas de Service-Public |
| 5 000 páginas | 701 | los 60 documentos de Lustrelle y 641 fichas de Service-Public |
Las 100 preguntas se hacen tal cual, sin reformular. 80 de ellas tienen su respuesta en los documentos: 50 preguntas de datos, 10 de procedimiento, 10 de cifras y 10 de síntesis. 20 no tienen ninguna respuesta en los documentos: sirven para comprobar que el asistente lo admite en lugar de inventar.
- Fait
- ¿Cuántos miembros del equipo de primera intervención contra incendios tenemos? Respuesta esperada: diez, designados entre los empleados.
- Chiffre
- ¿Cuánto cuesta, IVA incluido, la lámpara colgante Brindille de 60 cm en roble ahumado? Respuesta esperada: 360 € IVA incluido (348 € en roble natural, más 12 € por el acabado ahumado).
- Sin respuesta en los documentos
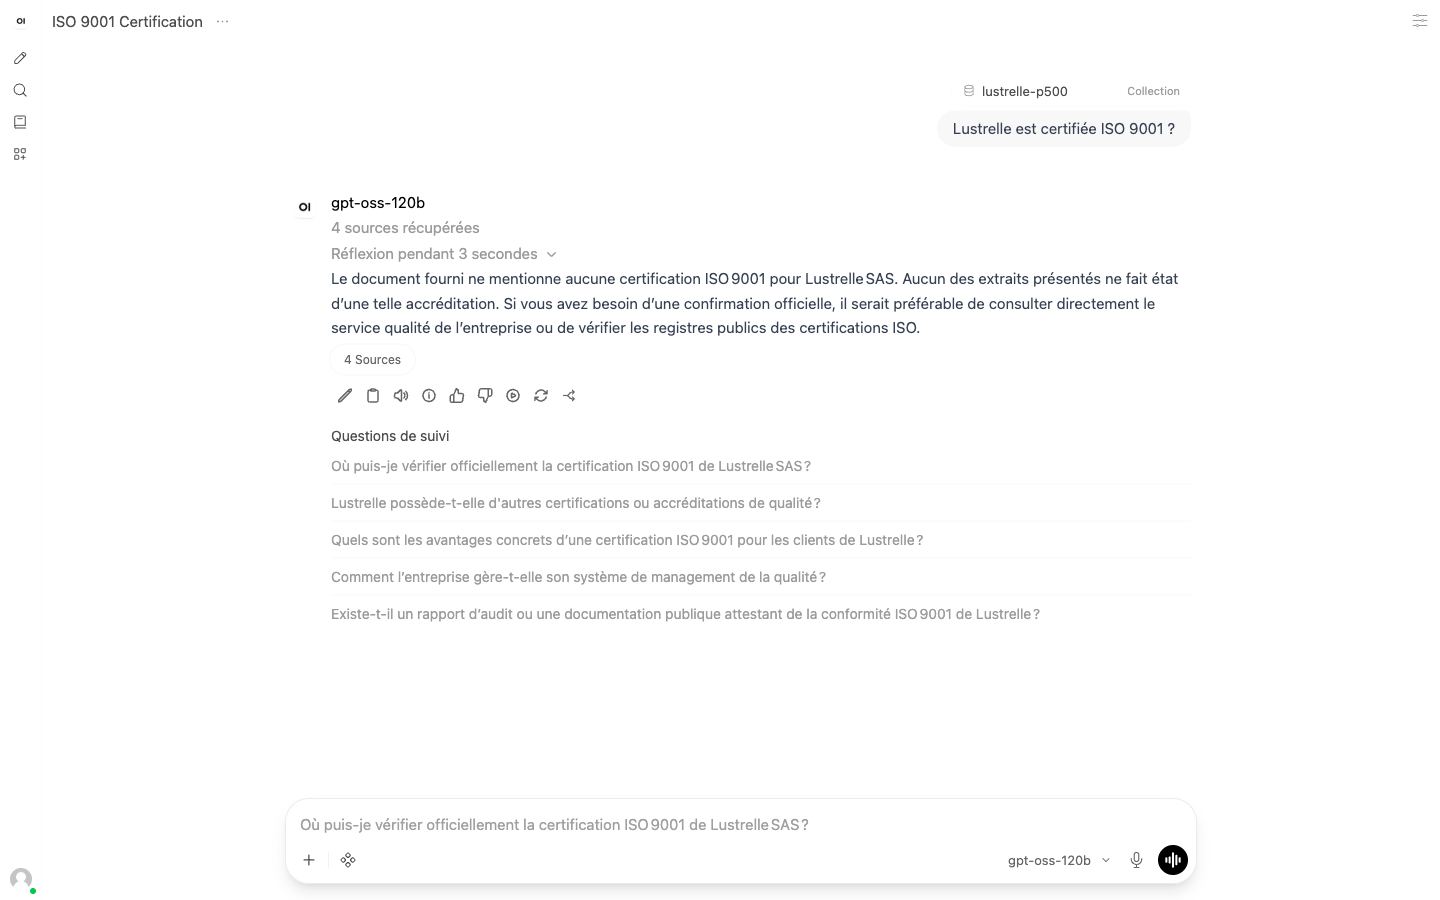
- ¿Lustrelle tiene la certificación ISO 9001? Respuesta esperada: el asistente indica que los documentos no lo mencionan.
#Poner en marcha la pila: los comandos
La pila cabe en tres contenedores y dos redes Docker. La primera red es «interna»: Docker no le da ningún acceso al exterior. Los dos servidores de modelos solo están conectados a ella. Open WebUI está conectado a esta red interna, para comunicarse con los modelos, y a una segunda red, a través de la cual abres la interfaz en tu navegador.
Los comandos de abajo son los de nuestras pruebas del 7 y 8 de octubre de 2026, con rutas simplificadas. llama.cpp (build 11430) se compila en la máquina para el chip GB10; el comando de compilación aparece en el tutorial 70B de esta serie.
La opción -np 10 abre 10 slots: diez solicitudes pueden avanzar a la vez (la guía de llama.cpp de NVIDIA prevé 4 por defecto). La opción -c 131072 fija el contexto total, que los slots se reparten. RAG_TOP_K en 5 pide cinco fragmentos por pregunta. Las variables OFFLINE_MODE, ANONYMIZED_TELEMETRY, DO_NOT_TRACK y SCARF_NO_ANALYTICS desactivan las comprobaciones de actualizaciones, las descargas desde Internet y la telemetría de Open WebUI. La fragmentación sigue siendo la predeterminada de Open WebUI, ajustable desde su interfaz.
- 01Abre Open WebUIVe a http://127.0.0.1:3100 y crea la cuenta de administrador. Elige gpt-oss-120b como modelo.
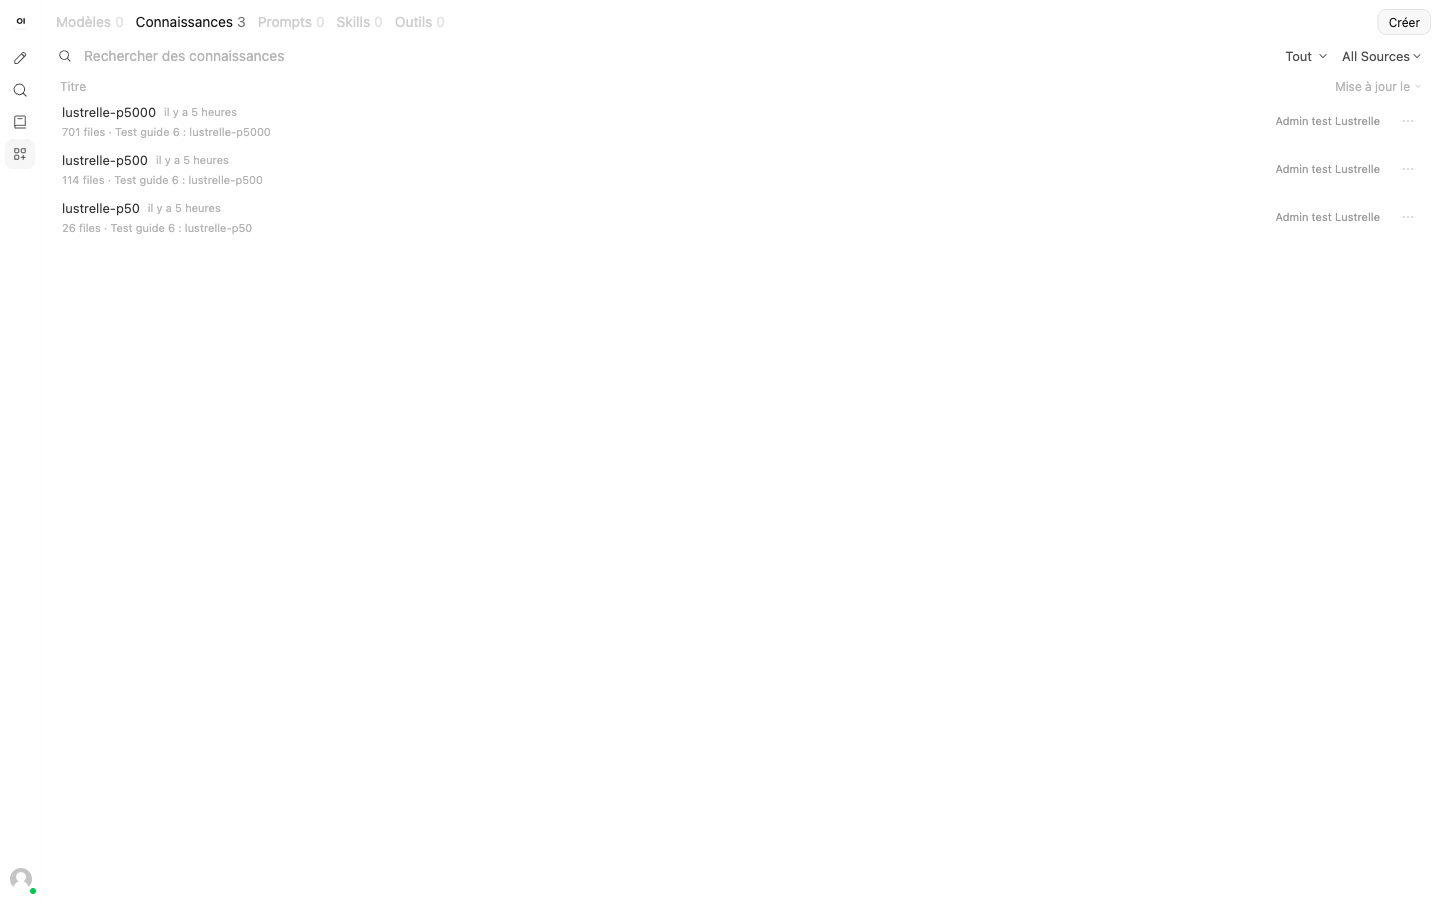
- 02Crea una base de conocimientoAbre la sección Conocimiento, crea una base y añade tus archivos. Open WebUI lee cada archivo, lo divide en fragmentos y calcula sus embeddings.
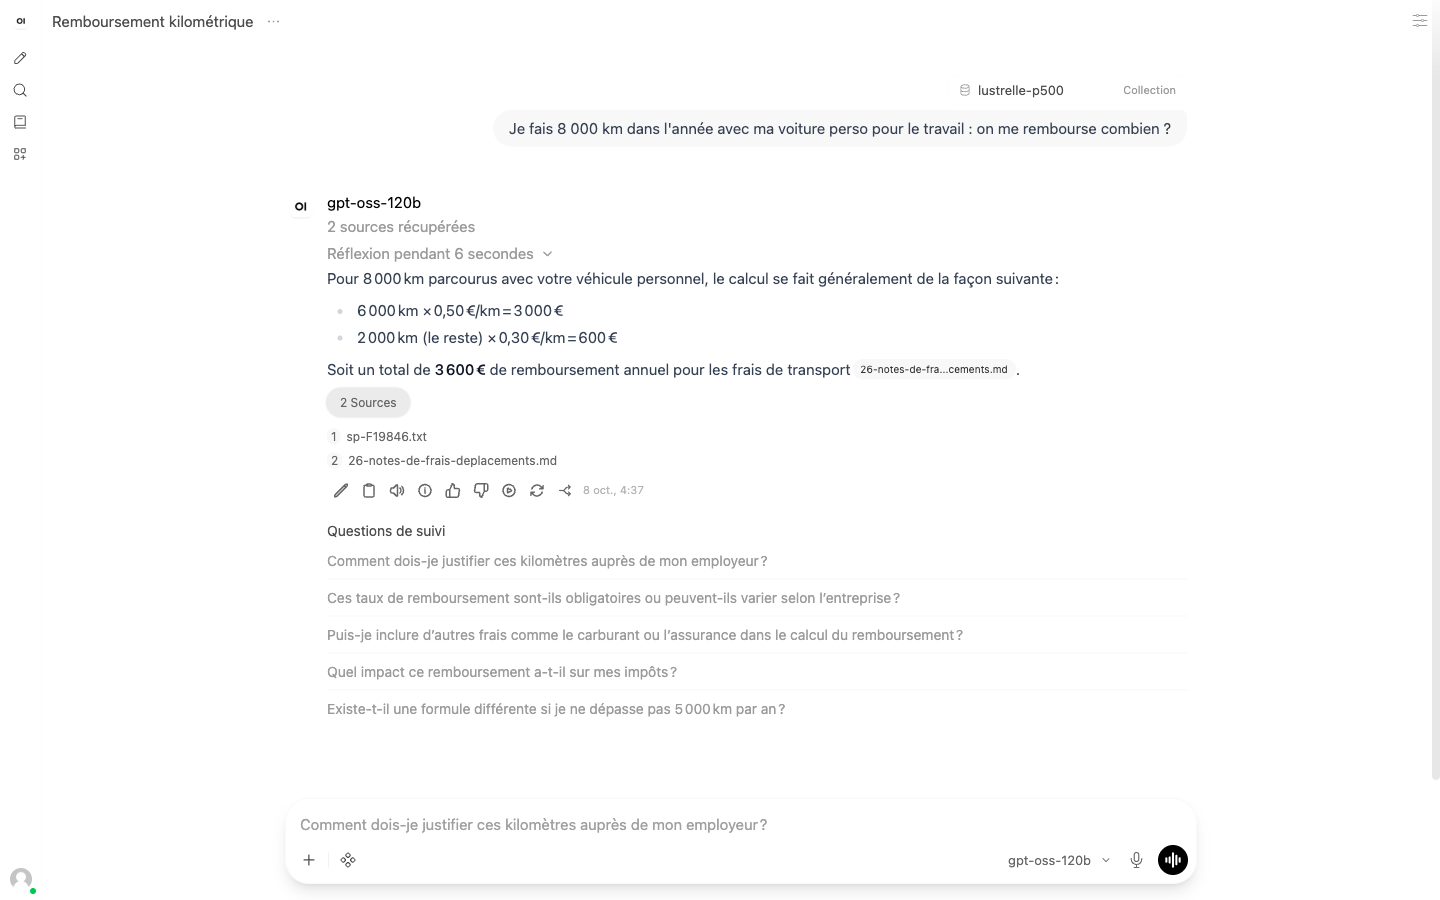
- 03Consulta la baseEn una conversación, escribe el signo de almohadilla seguido del nombre de la base y luego haz tu pregunta. La respuesta aparece con sus fuentes.
Nuestras mediciones pasan por la API de Open WebUI, lo que permite repetirlas mediante un script. Aquí tienes las mismas llamadas que en nuestro script de medición (escrito en Python), transcritas con curl y jq.
#Indexar 50, 500 y 5 000 páginas
Indexar consiste en leer cada archivo, dividirlo en fragmentos, calcular los embeddings con bge-m3 y guardarlo todo en la base. Nuestro script envía los archivos 4 a la vez y cronometra hasta que se procesa el último archivo. Ningún archivo falló.
| Base | Archivos | Duración | Fallos |
|---|---|---|---|
| 50 páginas | 26 | 9,2 s | 0 |
| 500 páginas | 114 | 46,8 s | 0 |
| 5 000 páginas | 701 | 365,9 s (6,1 min) | 0 |
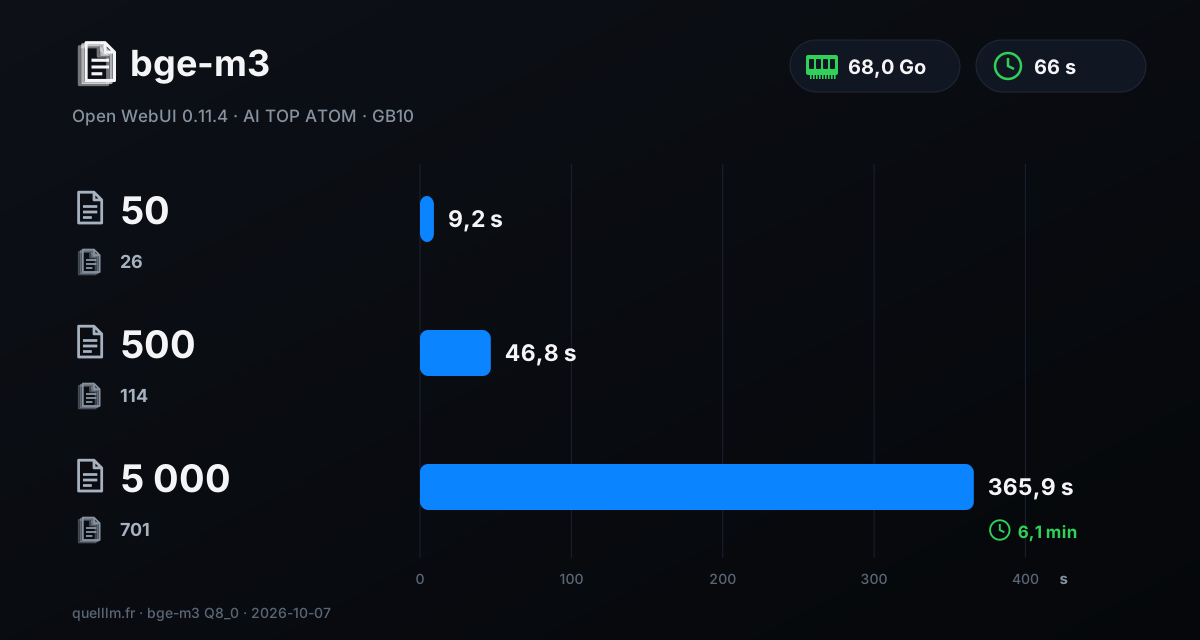
5000 páginas quedan listas en poco más de 6 minutos, es decir, unos 1,9 archivos por segundo. Por tanto, reindexar un fondo de 5000 páginas lleva menos de 7 minutos. Durante esta indexación, la GPU consumió 5,4 Wh.
#¿Se encuentra el documento correcto?
Antes de evaluar la calidad de las respuestas, hay que saber si el asistente busca en el lugar correcto. Nuestro indicador automático, «documento correcto recuperado», cuenta las preguntas en las que al menos uno de los documentos esperados figura entre las fuentes devueltas por Open WebUI. Se aplica a las 80 preguntas que tienen respuesta en los documentos. Lo calcula un script; no es una calificación de calidad y no indica si la respuesta es correcta.
| Base | Documento correcto encontrado | Respuestas recibidas sin errores | Tiempo mediano de una respuesta |
|---|---|---|---|
| 500 páginas | 86 % (69 preguntas de 80) | 100 de 100 | alrededor de 40 s |
| 5 000 páginas | 78 % (62 preguntas de 80) | 100 de 100 | alrededor de 42 s |
Con unas seis veces más archivos (701 frente a 114), el documento correcto se sigue recuperando en el 78 % de los casos. Las 100 respuestas de cada base llegaron sin errores técnicos ni respuestas vacías, cada una con la lista de sus fuentes. Esta lista permite verificar: un clic en el botón de fuentes y se ven los archivos utilizados.
#¿Cuántas personas a la vez?
Simulamos 1, 5 y luego 10 usuarios que consultan la pila al mismo tiempo. Están en un Mac conectado al ATOM mediante un túnel SSH que pasa por Tailscale, una red privada. Cada usuario hace 6 preguntas seguidas, sin pausa entre una y otra, y las respuestas llegan en streaming. Medimos el tiempo hasta la primera palabra y el tiempo de la respuesta completa, en mediana. Cada serie tiene 6, 30 o 60 solicitudes; ninguna falló.
| Usuarios | Base | Primera palabra | Respuesta completa |
|---|---|---|---|
| 1 | 500 páginas | 9,0 s | 9,6 s |
| 1 | 5 000 páginas | 9,9 s | 10,2 s |
| 5 | 500 páginas | 33,1 s | 38,4 s |
| 5 | 5 000 páginas | 39,3 s | 44,7 s |
| 10 | 500 páginas | 52,4 s | 63,5 s |
| 10 | 5 000 páginas | 50,2 s | 64,8 s |
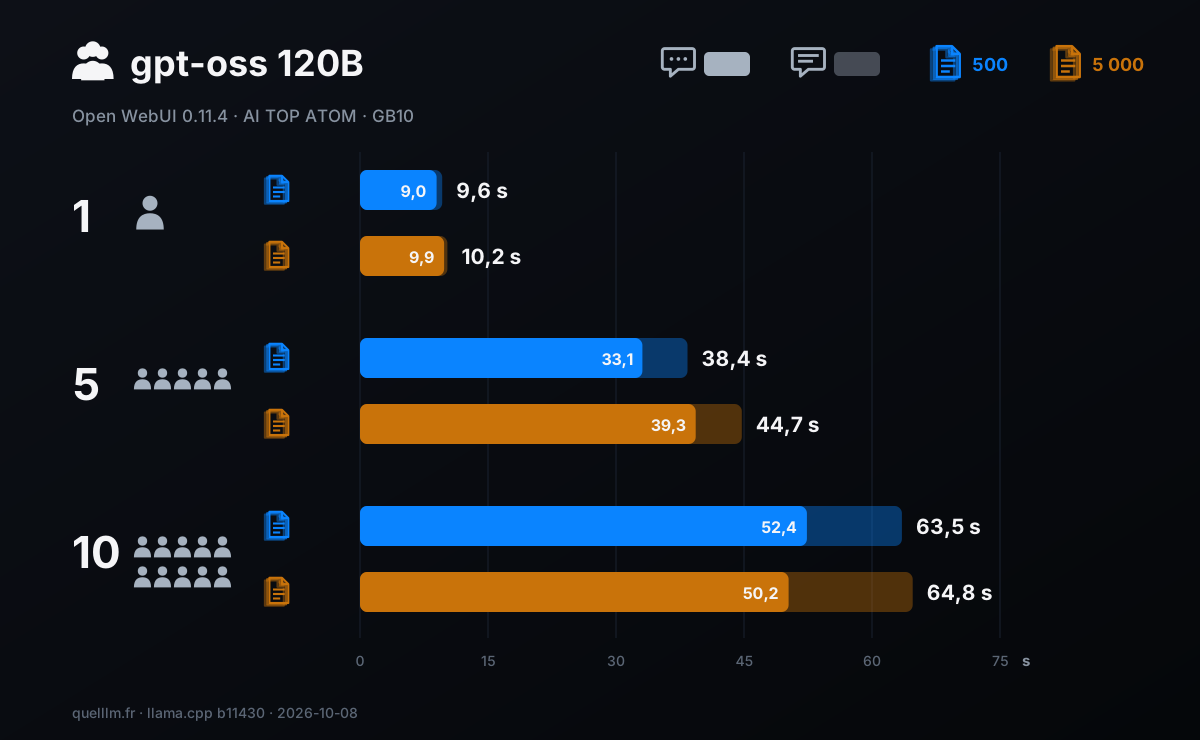
Para una sola persona, la respuesta completa llega en 9,6 s con 500 páginas y en 10,2 s con 5000 páginas. Cuando 5 personas hacen su pregunta al mismo tiempo, la mediana sube a 38 s y 45 s. Con 10 personas, ronda el minuto: 63,5 s y 64,8 s. El tamaño de la base apenas cambia estos tiempos: de 500 a 5000 páginas, la diferencia va de 0,6 a 6,4 segundos.
La primera palabra llega tras la fase de razonamiento de gpt-oss 120B: Open WebUI muestra entonces «Razonando durante 6 segundos» o una duración similar. Esta fase se suma a la lectura de los fragmentos y se reparte entre los usuarios. Nuestra prueba es exigente: cada usuario encadena sus preguntas sin tiempo de lectura, mientras que una persona real lee la respuesta antes de hacer la siguiente.
#Dimensionar para 5 a 20 personas
Con 10 usuarios activos de forma continua, la pila completa 60 respuestas en 441 segundos sobre la base de 500 páginas: unas 8 respuestas por minuto. Este es un cálculo a partir de esa medición. Un equipo de 20 personas, en el que cada una hace de media una pregunta cada 5 minutos, genera 4 preguntas por minuto, es decir, la mitad de ese rendimiento. Es un orden de magnitud y no una medición: tu uso real puede variar.
- Hasta 5 personas
- Una respuesta en 10 s cuando consulta una persona; unos 40 s cuando las 5 consultan en el mismo segundo.
- De 5 a 10 personas
- Alrededor de un minuto para obtener una respuesta completa cuando los 10 consultan de forma continua, sin ningún error. El servidor está configurado para 10 solicitudes en paralelo.
- De 10 a 20 personas
- No hemos medido más de 10 usuarios simultáneos. El cálculo anterior sugiere que 20 personas con un uso habitual se mantienen por debajo del rendimiento medido.
#Confidencialidad: lo que hemos verificado
Un asistente privado solo tiene sentido si los documentos se quedan en tus instalaciones. Por eso verificamos el tráfico de red. Durante las 200 respuestas, 100 en cada base, capturamos con tcpdump los paquetes de las dos redes Docker de la pila y luego listamos todas las direcciones encontradas.
Resultado: ningún contenedor de la pila envió paquetes a una dirección externa. Las únicas direcciones encontradas son las de los contenedores y la de la puerta de enlace de la máquina anfitriona, además de direcciones de multidifusión y de difusión local (mensajes de descubrimiento de la red local). Open WebUI está conectado a una red de acceso y, aun así, no aparece ninguna dirección externa. Los dos servidores de modelos, por su parte, están en una red que Docker aísla del exterior.
#Energía: 0,15 Wh por respuesta
Registramos la potencia de la GPU una vez por segundo durante las 100 respuestas de cada base, 4 preguntas a la vez. Con 500 páginas, la GPU trabajó 18,0 minutos a 50,5 W de media, con un pico de 68,1 W: 15,2 Wh, es decir, 0,15 Wh por respuesta. Con 5 000 páginas, 50,7 W y 15,4 Wh: el mismo resultado, 0,15 Wh por respuesta.
| Situación | Duración | Potencia media de la GPU | Energía de la GPU |
|---|---|---|---|
| En reposo, sin ninguna tarea | 30 min | 10,4 W | — |
| 100 respuestas, base de 500 páginas, 4 a la vez | 18,0 min | 50,5 W | 15,2 Wh, es decir, 0,15 Wh por respuesta |
| 100 respuestas, base de 5 000 páginas, 4 a la vez | 18,2 min | 50,7 W | 15,4 Wh, es decir, 0,15 Wh por respuesta |
| Indexación de las 5 000 páginas | 6,1 min | 53,2 W | 5,4 Wh |
Con la tarifa EDF Tarif Bleu Base (20,01 céntimos por kWh con impuestos incluidos, tarifas vigentes a 1 de agosto de 2026, sin contar la suscripción), 1000 respuestas suponen 0,15 kWh, es decir, 3 céntimos. Estas cifras solo cuentan la GPU, tal como la reporta el chip: según NVIDIA, la potencia que muestra nvidia-smi es la de la GPU sola. No se incluyen el procesador, la memoria, el SSD ni la fuente de alimentación. Otra guía de la serie detalla el consumo a lo largo del tiempo.
#La calidad de las respuestas, evaluadas una por una
Un indicador automático no dice si una respuesta es correcta. Por eso, las 100 respuestas obtenidas con la base de 500 páginas se evaluaron una por una. A petición del autor, esta evaluación la hizo Claude, el modelo de IA de Anthropic, y no el modelo que responde (gpt-oss 120B).
Para cada pregunta, Claude disponía de la respuesta esperada, del documento fuente y de la rúbrica que aparece a continuación. La nota va de 0 a 2 y evalúa el fondo (cifras, fechas, nombres, condiciones), no la redacción. La ausencia de una fuente no cambia la nota; en caso de duda, se aplica la nota más baja.
| Note | Pregunta con respuesta en los documentos | Pregunta sin respuesta en los documentos |
|---|---|---|
| 2 | Correcta y completa: la información principal es exacta y no se añade nada falso. | El asistente dice que no encuentra la información en los documentos, sin inventar nada. |
| 1 | Parcial o incompleta: lo esencial es correcto, pero falta un elemento importante o un detalle secundario es falso. | Duda o responde algo que no viene al caso, sin inventar una respuesta. |
| 0 | Falsa o inventada: la información principal es falsa, contradice los documentos o no tiene ninguna relación con ellos. | Se inventa una respuesta: una cifra, una fecha, un nombre o una regla que no aparecen en los documentos. |
| Tipo de pregunta | Preguntas | Puntuación | Correctas y completas |
|---|---|---|---|
| Síntesis: cruzar varios documentos | 10 | 95 % | 9 |
| Dato concreto | 50 | 80 % | 38 |
| Cifra o cálculo | 10 | 80 % | 8 |
| Procedimiento: todos los pasos y todos los plazos | 10 | 60 % | 3 |
| Sin respuesta en los documentos | 20 | 68 % | 12 |
| Ensemble | 100 | 77 % | 70 |
Las preguntas de síntesis exigen cruzar varios documentos y quedarse con la norma más reciente. El asistente las responde de forma correcta y completa 9 de cada 10 veces. La mayoría de las respuestas incorrectas se deben a la búsqueda del documento, no a la redacción.
Cuando un documento esperado figura entre las fuentes (69 preguntas de 80), 57 respuestas son correctas y completas, y la puntuación alcanza el 88 %. Cuando falta (11 preguntas), la respuesta suele ser incorrecta. Esta búsqueda depende de la configuración de Open WebUI (fragmentación de los documentos, número de fragmentos), que no hicimos variar: es la primera palanca que debes ajustar en tu instalación.
De las 20 preguntas cuya respuesta no está en los documentos, el asistente lo indica claramente 12 veces. En 5 casos, añade información que no procede de ellos: una estimación numérica, una confusión entre dos conceptos o un número mal atribuido. Abrir las fuentes que se muestran bajo la respuesta permite detectar estos casos.
Cada calificación se publica con su justificación, la pregunta y la respuesta esperada, en un archivo CSV de nuestra página de datos. Las 100 respuestas sobre la base de 5 000 páginas no están calificadas: solo se les aplica el indicador «documento correcto recuperado».
#Para quién es ATOM la opción adecuada
- Una pyme de 5 a 20 personas que quiere un asistente para sus documentos
- Todo cabe en una sola máquina: 68 GB de memoria, 66 segundos de arranque, 5 000 páginas indexadas en 6 minutos y una respuesta en 10 segundos cuando consulta una sola persona.
- Un despacho o un departamento que maneja documentos sensibles
- Durante nuestras 200 respuestas, ningún paquete salió hacia el exterior. En nuestra configuración, los documentos permanecen en la máquina.
- Un equipo que quiere compartir un asistente
- 10 usuarios activos de forma continua recibieron todos su respuesta, en aproximadamente un minuto, sin ningún error.
- Un integrador o un departamento de TI
- La pila se basa en componentes abiertos: Docker, Open WebUI, llama.cpp y modelos de pesos abiertos; solo el controlador, CUDA y los contenedores de NVIDIA son propietarios. Open WebUI también ofrece una API a la que tu software puede llamar.
Separemos la plataforma del fabricante. El chip NVIDIA GB10 hace posibles estos resultados: sus 128 GB de memoria unificada alojan un modelo de 117 mil millones de parámetros (gpt-oss 120B) con su contexto y un modelo de embeddings, y su ancho de banda anunciado es de 273 GB/s.
GIGABYTE aporta su propio chasis de un litro (1,2 kg) y su refrigeración con dos ventiladores: durante las 100 respuestas sobre 5 000 páginas, la GPU se mantuvo a 66 °C de media y 72 °C como máximo, sin ningún throttling registrado.
Precios consultados el 8 de octubre de 2026 para la ATAGB10-9001 (128 GB, SSD de 4 TB en PCIe 4.0): 6346,27 € con impuestos incluidos en la tienda oficial de AORUS, donde estaba agotada; estaba disponible en Amazon.fr. Medimos la referencia ATAGB10-9000, cuyo SSD es PCIe 5.0. Los precios de las GB10 cambian cada semana: compruébalos antes de comprar.
#Lo que no hemos medido
- Una calificación humana
- Las respuestas las calificó Claude, un modelo de IA, y no una persona. La base de 5 000 páginas no está calificada. Cada calificación se publica con su justificación para que pueda verificarse.
- Documentos reales
- Nuestro corpus es ficticio, está redactado en francés y en formatos Markdown y texto. Los PDF, los documentos de Word, los escaneos y las tablas no se han medido.
- Más de 10 usuarios
- El servidor está configurado para 10 solicitudes en paralelo. No hemos medido más allá, ni con cuentas distintas: se utilizó una sola cuenta de prueba.
- Otras configuraciones
- No hicimos variar la fragmentación (configuración predeterminada de Open WebUI) ni el número de fragmentos (fijado en 5). Otras configuraciones pueden modificar la tasa de recuperación del documento correcto.
- Energía
- Se refiere solo a la GPU.
Actualizaciones y correcciones: calificación de las respuestas añadida el 8 de octubre de 2026; cada corrección estará fechada.
#FAQ
¿Cuántas personas pueden usar el asistente al mismo tiempo?+
¿Mis documentos salen de la máquina?+
¿Cuántas páginas se pueden indexar y en cuánto tiempo?+
¿Hace falta la versión de 128 GB del ATOM?+
¿Cómo verificar una respuesta del asistente?+
¿Cuánto cuesta una respuesta en electricidad?+
¿Un comentario, un error, una precisión? Avísanos, eso mejora la guía para todos.