GB10 de 128 GB: qué LLM funcionan de verdad (mesures)
En una GIGABYTE AI TOP ATOM (NVIDIA GB10, 128 GB), los 13 modelos medidos, del 4B al 235B, funcionan con 32 768 tokens de contexto y al menos 20 GB de margen. Los modelos MoE grandes, que solo activan una parte de sus parámetros en cada token, son mucho más rápidos que un modelo denso del mismo tamaño: gpt-oss 120B escribe 58 tokens por segundo. Un modelo denso de 70B escribe a 4,8 tokens por segundo: es el ancho de banda de memoria, y no el espacio, lo que determina la velocidad.
Ciento veintiocho gigabytes de memoria unificada: esa es la ventaja de las máquinas GB10 frente a las tarjetas gráficas. Pero ¿qué se puede cargar realmente en ellas, con qué margen y a qué velocidad? Hemos medido 13 modelos, del 4B al 235B, en una AI TOP ATOM proporcionada gratuitamente por GIGABYTE, con un protocolo fijado antes de la primera medición. Esto es lo que cabe, lo que resulta agradable en el día a día y para quién es la compra adecuada.
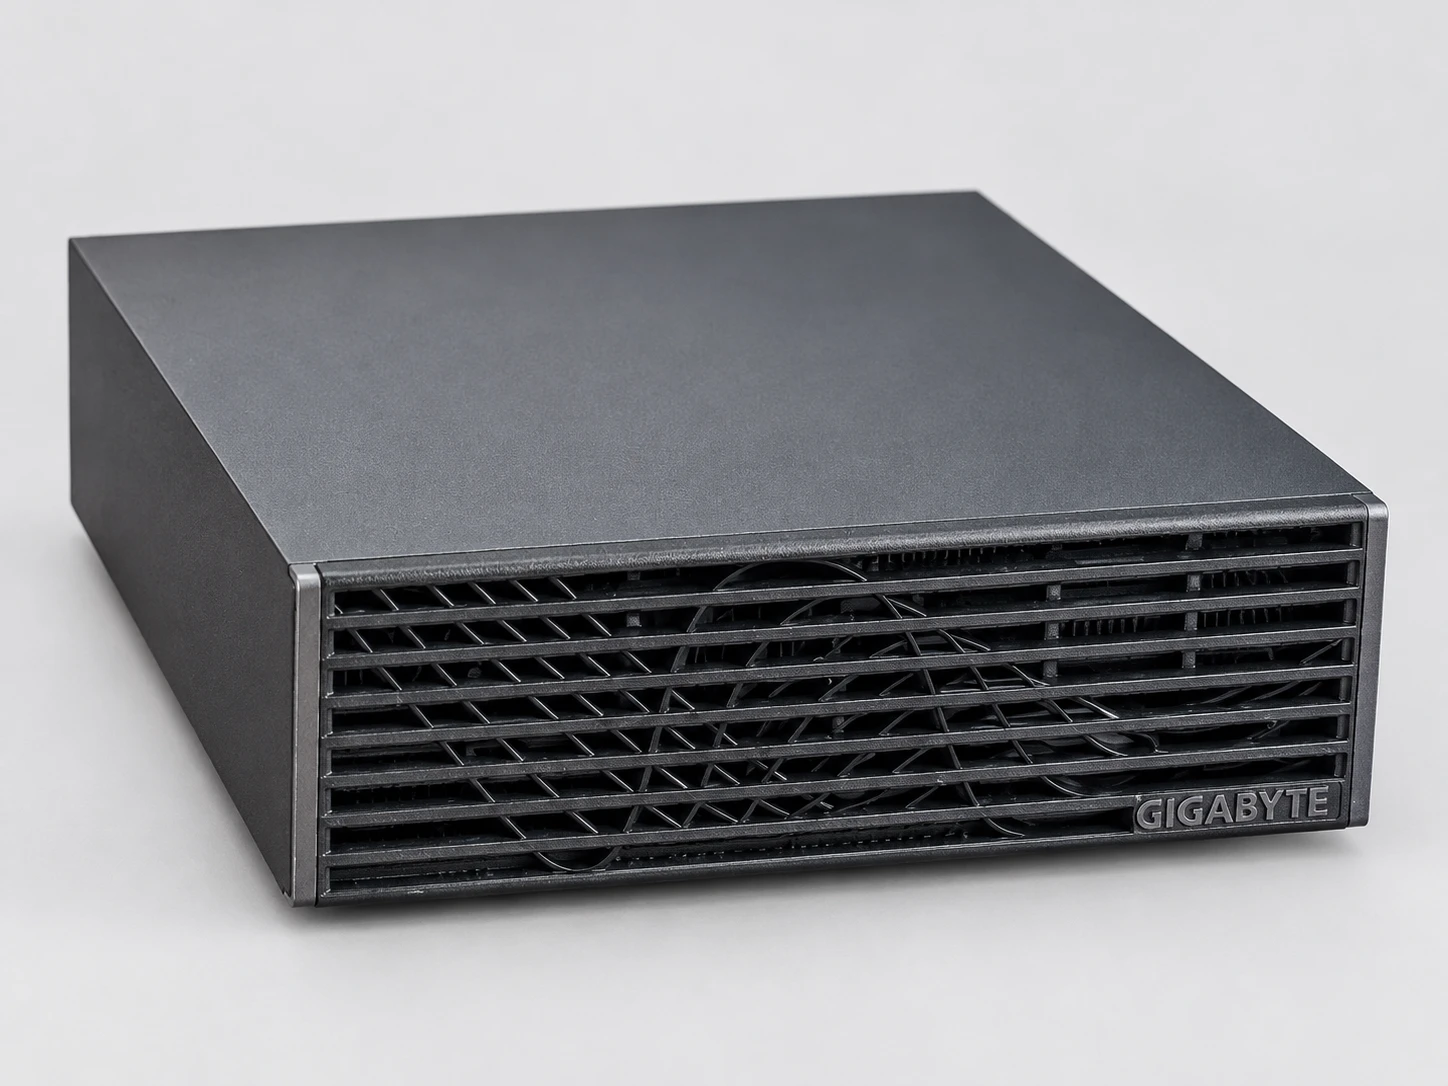
#La máquina probada
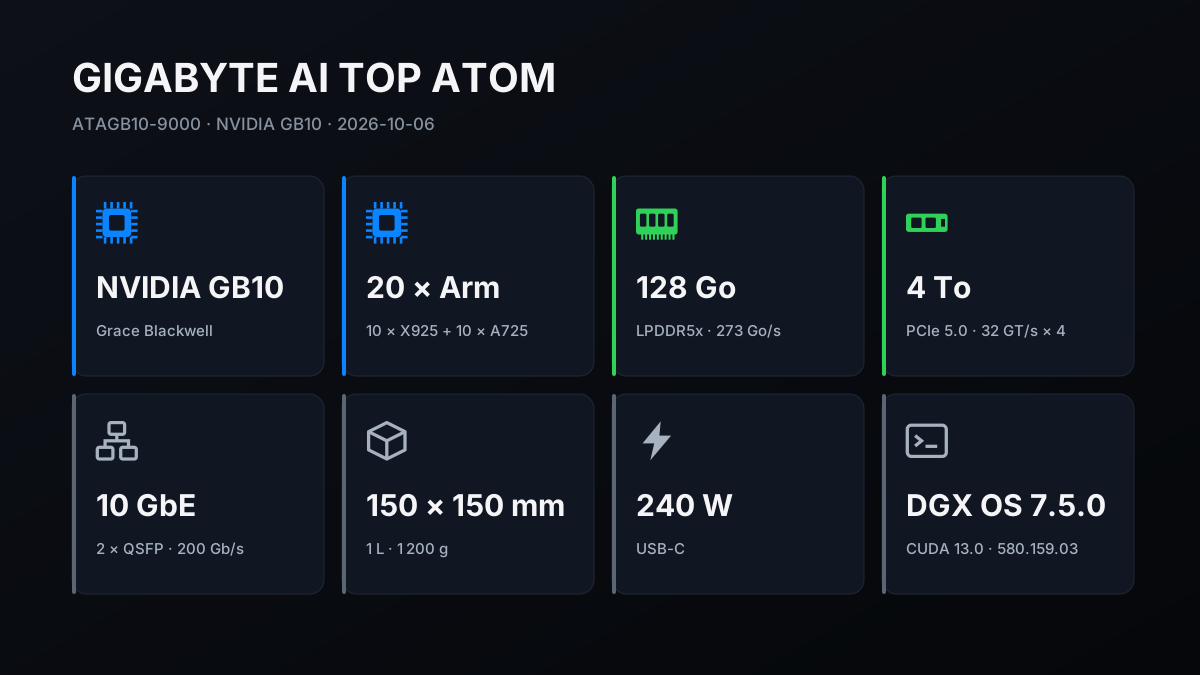
La máquina es una GIGABYTE AI TOP ATOM, referencia ATAGB10-9000: chip NVIDIA GB10 (20 núcleos Arm y una GPU Blackwell que comparte 128 GB de memoria anunciada a 273 GB/s), SSD de 4 TB en PCIe 5.0. Funciona con DGX OS 7.5.0, el sistema de NVIDIA basado en Ubuntu (controlador 580.159.03, CUDA 13.0).
Se utilizaron tres programas. llama.cpp, un motor open source muy extendido para ejecutar modelos localmente, compilado en el propio equipo para el chip GB10, proporciona la tabla principal. Ollama 0.34.1 sirve para compararlo con un MacBook Pro M5 Max medido con la misma versión. vLLM 26.09, un servidor diseñado para responder a varias personas a la vez, se ejecuta en el contenedor proporcionado por NVIDIA.
#Cómo medimos
Las velocidades de llama.cpp proceden de cinco repeticiones, con una desviación estándar (la dispersión entre repeticiones) de como máximo un 3 %. Los tiempos de carga, la lectura de un documento de 30 000 tokens y los márgenes de memoria son mediciones únicas; las pruebas con varios usuarios se repiten tres veces. Antes de la primera medición, una prueba de tres minutos verificó que la GPU mantuviera su potencia de cálculo.
Los archivos de los 13 modelos tienen una huella SHA-256 (una firma digital del archivo) idéntica a la publicada por Hugging Face, el sitio que aloja estos modelos. El protocolo, redactado el 5 de octubre, quedó fijado el 6 a las 13:30, antes de la primera medición.
Una adenda del mismo día, hacia las 16:50, adelantó a la tarde la nueva medición en frío y añadió las pruebas que se reproducen aquí: script oficial de Ollama, decodificación especulativa, carga continua y Llama 3.3 70B en NVFP4. El método, las huellas de los archivos y los datos de nuestras tablas están publicados en nuestra página sobre el método.
Las cifras principales se volvieron a medir en frío esa misma noche, después de 20 minutos de reposo y con la caché vaciada: como máximo un 2,6 % de diferencia, por debajo del umbral del 3 % del protocolo.
#La misma velocidad que un DGX Spark, con una diferencia de unos pocos puntos porcentuales
Hasta donde sabemos, las máquinas GB10 de 128 GB comparten el mismo chip NVIDIA y la misma memoria; su construcción, refrigeración y almacenamiento pueden diferir. Para situar el ATOM, repetimos dos referencias publicadas para el DGX Spark de NVIDIA, con la misma versión del software y los mismos ajustes.
Con llama.cpp (build 7941, el de la tabla publicada por el proyecto; nuestra tabla principal utiliza el build 11430, más reciente), en seis modelos comunes, la lectura es idéntica con una diferencia de hasta el 2,3 %; la escritura es inferior en un 2,8 % de mediana y en un 4,3 % como máximo. Con el script oficial de Ollama (versión 0.12.6, la de sus mediciones publicadas), nuestras tres mediciones difieren como máximo un 2 %, tanto en lectura como en escritura: gpt-oss 20B, gpt-oss 120B y Llama 3.1 70B.
Por tanto, las velocidades de esta guía deberían ser válidas, con una diferencia de pocos puntos porcentuales, para las demás máquinas GB10 de 128 GB; solo hemos medido la ATOM. Su construcción y su comportamiento bajo carga (temperaturas, estabilidad durante 1 h y 2 h) se detallan en la siguiente guía de la serie, y su consumo, en una guía específica.
#13 modelos, de 4B a 235B: espacio ocupado y velocidad
La tabla resume la campaña. «Memoria ocupada» es la reducción de memoria disponible una vez cargado el modelo, con 32 768 tokens de contexto reservados. «Carga» es el tiempo de carga en frío, con la caché de disco vaciada. Las velocidades proceden de la herramienta de medición llama-bench (llama.cpp, build 11430 del 5 de octubre de 2026), primero con el contexto vacío y después con 32 768 tokens ya presentes; las duraciones reales para un documento largo aparecen más abajo.
| Modelo | Tipo | Memoria ocupada | Chargement | Escritura (vacío → 32k) | Lectura (vacío → 32k) | Uso |
|---|---|---|---|---|---|---|
| Gemma 3 4B (Q4_0) | dense | 4,6 GB | 3 s | 80,8 → 63,6 | 6 239 → 5 409 | muy fluido |
| Qwen2.5-Coder 7B (Q8_0) | dense | 10,2 GB | 3 s | 30,0 → 23,3 | 3 746 → 2 138 | fluide |
| gpt-oss 20B (MXFP4) | MoE, 3,6 Md activos | 13,0 GB | 4 s | 81,4 → 62,5 | 4 950 → 3 316 | muy fluido |
| Qwen3.8 27B (Q4_K_XL) | dense | 19,1 GB | 5 s | 11,8 → 10,6 | 865 → 717 | correct |
| Qwen3.6 35B-A3B (Q4_K_XL) | MoE, 3 Md activos | 22,4 GB | 5 s | 66,0 → 55,6 | 2 987 → 2 429 | muy fluido |
| GLM-4.7-Flash (Q8_0) | MoE, 3 Md activos | 32,6 GB | 6 s | 51,4 → 35,5 | 2 392 → 608 | muy fluido |
| Qwen3-Coder 30B-A3B (Q8_0) | MoE, 3,3 Md activos | 34,3 GB | 6 s | 62,6 → 33,2 | 3 377 → 1 603 | muy fluido |
| Llama 3.3 70B (Q4_K_M) | dense | 51,1 GB | 8 s | 4,8 → 3,9 | 405 → 269 | ideal para el procesamiento por lotes |
| gpt-oss 120B (MXFP4) | MoE, 5,1 Md activos | 61,7 GB | 10 s | 58,0 → 42,2 | 2 609 → 1 832 | muy fluido |
| Qwen3.5 122B-A10B (Q4_K_XL) | MoE, 10 Md activos | 74,5 GB | 12 s | 23,1 → 21,4 | 1 126 → 945 | fluide |
| Nemotron-3 Super 120B-A12B (Q4_K_XL) | MoE, 12 Md activos | 80,4 GB | 12 s | 16,9 → 16,5 | 851 → 809 | correct |
| Qwen3.8-Flash-Next 125B (IQ4_XS) | MoE, aproximadamente 6 Md activos | 89,5 GB | 21 s | 27,3 → 25,2 | 1 073 → 917 | fluide |
| Qwen3-235B-A22B (Q2_K_XL) | MoE, 22 Md activos | 90,5 GB | 12 s | 17,7 → 11,8 | 588 → 331 | correcto; compresión fuerte (Q2) |
Para leer la tabla: un modelo denso utiliza todos sus parámetros en cada token, mientras que un modelo MoE (« mixture of experts ») solo utiliza una fracción, indicada en miles de millones (Md). La sigla entre paréntesis designa la compresión de los pesos. En nuestros archivos, Q8 ocupa 8,5 bits por parámetro, los formatos Q4 y MXFP4 de 4,3 a 5,6 bits, y Q2_K_XL 3 bits: es la compresión más fuerte de la tabla.
La columna «Uso» aplica nuestras referencias a la velocidad de escritura con el contexto vacío: muy fluido por encima de 40 tokens por segundo, fluido de 20 a 40 y correcto de 10 a 20. Por debajo de ese nivel, reservamos el modelo para procesos por lotes.
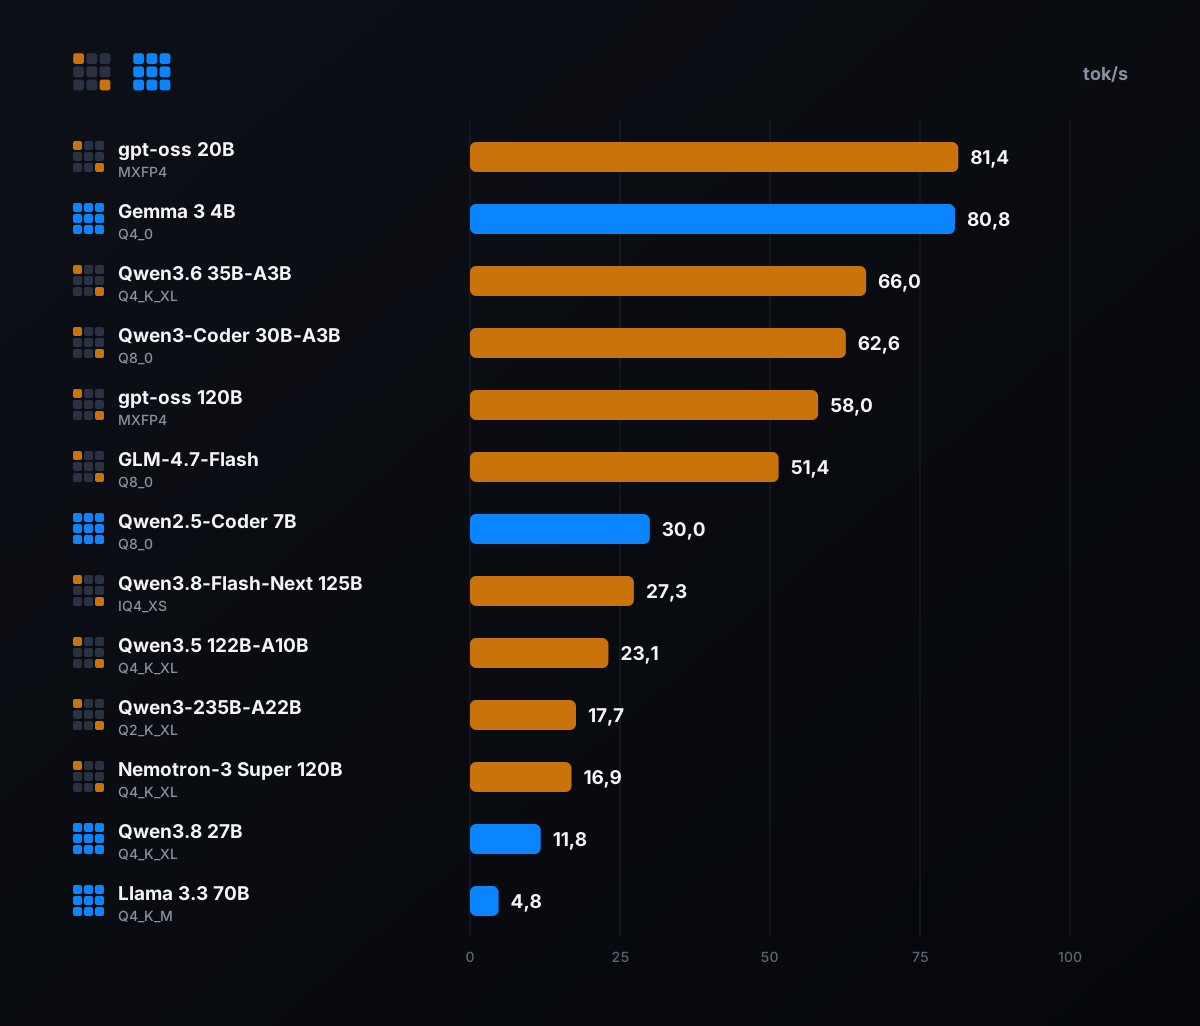
Primera conclusión: nada en esta tabla pone la máquina en dificultades; incluso Qwen3-235B deja 21 GB libres con 30 000 tokens de contexto. Segunda conclusión, más útil para elegir: el espacio casi nunca es un límite; es la elección del modelo la que determina la velocidad, de 4,8 a 81,4 tokens por segundo.
#Lo que determina la velocidad: los parámetros activos, no el tamaño
Para escribir cada token, el chip debe volver a leer en memoria los pesos que sirven para ese token. Con 273 GB/s de ancho de banda, la velocidad máxima se calcula fácilmente: 273 dividido por el volumen de pesos leídos para cada token. Un modelo denso lee todos sus pesos cada vez; un modelo MoE solo lee una fracción, los «expertos» elegidos para ese token.
Esto explica la paradoja de la tabla. El archivo de gpt-oss 120B pesa 59 GB, pero el modelo solo activa 5,1 mil millones de parámetros por token: escribe a 58,0 tokens por segundo. Qwen3.8 27B, cuyo archivo pesa más de tres veces menos (16 GB), es un modelo denso: activa sus 27 mil millones de parámetros con cada token y escribe a 11,8 tokens por segundo. El modelo grande va casi cinco veces más rápido que el pequeño.
| Modelo | Parámetros activos | Límite teórico | Medido | Porcentaje del límite |
|---|---|---|---|---|
| Qwen2.5-Coder 7B (denso) | 7,6 Md | 33,7 | 30,0 | 89 % |
| Llama 3.3 70B (denso) | 70,6 Md | 6,4 | 4,8 | 74 % |
| Qwen3.8 27B (denso) | 27,3 Md | 15,6 | 11,8 | 76 % |
| Qwen3-Coder 30B-A3B (MoE) | 3,3 Md | 77,8 | 62,6 | 81 % |
| gpt-oss 120B (MoE) | 5,1 Md | 98,7 | 58,0 | 59 % |
| Qwen3.6 35B-A3B (MoE) | 3 Md | 141,1 | 66,0 | 47 % |
La tabla recoge seis modelos, aquellos cuyo número de parámetros activos está publicado o ha sido medido por llama.cpp. Los modelos densos alcanzan entre el 74 y el 89 % de este límite: la GB10 aprovecha casi toda su memoria.
En el conjunto de los trece modelos, los ocho MoE fuera de Qwen3.8-Flash-Next alcanzan entre el 47 y el 81 %, seis de ellos entre el 52 y el 62 %; la selección de expertos y los cálculos adicionales probablemente añaden un tiempo fijo a cada token. Qwen3.8-Flash-Next no entra en este cálculo: cuenta con 51 mil millones de parámetros de tabla de consulta además de sus 125 mil millones, lo que hace que la estimación no sea adecuada.
A igualdad de tamaño, los MoE siguen siendo mucho más rápidos. De ahí nuestro consejo principal: en una máquina GB10, para un modelo grande, prioriza un MoE. Un modelo denso pequeño como Gemma 3 4B también escribe muy rápido (80,8 tokens por segundo), pero es mucho más pequeño y sirve para otros usos.
#Los modelos de más de 100 mil millones de parámetros
Esta es la razón de ser de los 128 GB. NVIDIA anuncia para la plataforma modelos de hasta 200 mil millones de parámetros; nuestras mediciones confirman esa promesa, y un modelo 235B comprimido a 3 bits incluso cabe más allá. Cinco modelos de más de 100 mil millones de parámetros caben en la ATOM, todos con al menos 20 GB de margen con un contexto de 30 000 tokens.
- gpt-oss 120B, el mejor equilibrio entre velocidad y espacio
- 58,0 tokens por segundo, 61,7 GB ocupados con su contexto y cargado en 10 segundos. OpenAI lo publica directamente en formato MXFP4: cabe sin compresión adicional.
- Qwen3.8-Flash-Next 125B, el más rápido de los Qwen gigantes
- 27,3 tokens por segundo con aproximadamente 6 mil millones de parámetros activos, 89,5 GB ocupados en IQ4_XS. Su versión Q4_K_XL, menos comprimida, también cabe, aunque con un margen estrecho (véase más abajo).
- Qwen3.5 122B-A10B
- 23,1 tokens por segundo, 74,5 GB; sus diez mil millones de parámetros activos lo sitúan por detrás de gpt-oss.
- Nemotron-3 Super 120B-A12B (NVIDIA)
- 16,9 tokens por segundo, 80,4 GB. Con doce mil millones de parámetros activos, escribe más despacio que gpt-oss, y es el modelo cuya escritura se mantiene mejor cuando el contexto se alarga: de 16,5 a 32 768 tokens, aproximadamente un 3 % menos.
- Qwen3-235B-A22B, por separado
- Cabe en Q2_K_XL, la compresión más fuerte de la tabla (3 bits por parámetro de media): 17,7 tokens por segundo, 90,5 GB. Una compresión tan fuerte suele reducir la calidad de las respuestas; no la hemos medido.
#Dónde termina la memoria: alrededor de 100-105 GB de pesos
El sistema ve 121,7 GB de memoria: una parte de los 128 queda reservada desde el arranque. Una vez iniciada la máquina, sin nada más en memoria, quedaban disponibles entre 108 y 113 GB según el momento. Para encontrar el límite, cargamos dos versiones más pesadas de los modelos más grandes, con el mismo contexto de 32 768 tokens y un mecanismo de seguridad que interrumpe la carga si la memoria libre baja de 3 GB.
| Modelo | Archivo | Memoria ocupada | Espacio restante | Escritura (después de leer de 4 000 a 30 000 tokens) | Place |
|---|---|---|---|---|---|
| Qwen3.8-Flash-Next 125B (Q4_K_XL) | 103,7 GB | 107,0 GB | 6,0 GB | 24,9 → 21,9 tok/s | justo |
| Qwen3-235B-A22B (Q3_K_XL, 3,5 bits) | 97,0 GB | 104,7 GB | 8,2 GB | 13,9 → 10,4 tok/s | justo |
Ningún modelo falló al cargarse, pero estos dos dejan un margen estrecho: apenas hay espacio para un segundo modelo, un contexto mucho más largo o una aplicación exigente al lado. Por tanto, el límite práctico se sitúa en torno a 100-105 GB de pesos. Esto excluye, por ejemplo, los pesos NVFP4 (un formato comprimido de NVIDIA) de Qwen3.8-Flash-Next: unos 135 GB según el blog de Kubesimplify (27 de agosto de 2026), que precisa que en ese caso hacen falta dos máquinas.
Esta misma publicación ya mostraba el modelo en una sola máquina en GGUF (el formato de llama.cpp), pero entonces solo existía la versión más comprimida. En ATOM funcionan las versiones IQ4_XS y Q4_K_XL, con 21 y 6 GB de margen.
#El precio del contexto largo
Un documento largo, una base de código o una conversación que se alarga: cada token ya presente en el contexto ralentiza lo que sigue. Con 32 768 tokens en memoria, la velocidad de escritura disminuye entre un 3 y un 47 % según los modelos. También medimos el tiempo real necesario para leer de una vez un documento de 30 000 tokens, unas cincuenta páginas.
| Modelo | Lectura de 30 000 tokens | Escritura después |
|---|---|---|
| Gemma 3 4B | 4,7 s | 60,8 tok/s |
| gpt-oss 20B | 8,1 s | 61,6 tok/s |
| Qwen2.5-Coder 7B | 12,7 s | 23,3 tok/s |
| Qwen3.6 35B-A3B | 14,2 s | 54,4 tok/s |
| Qwen3-Coder 30B-A3B | 17,4 s | 33,3 tok/s |
| gpt-oss 120B | 21,8 s | 42,8 tok/s |
| GLM-4.7-Flash | 32,7 s | 35,6 tok/s |
| Qwen3.8 27B | 39,4 s | 10,6 tok/s |
| Qwen3.8-Flash-Next 125B | 42,9 s | 23,0 tok/s |
| Qwen3.5 122B-A10B | 43,6 s | 21,2 tok/s |
| Nemotron-3 Super 120B-A12B | 55,4 s | 16,2 tok/s |
| Qwen3-235B-A22B | 1 min 33 s | 12,1 tok/s |
| Llama 3.3 70B | 1 min 44 s | 4,0 tok/s |
Para la mayoría de los modelos, estos tiempos son más largos de lo que sugiere la columna «Lectura» de la primera tabla. La razón probable: llama-server, el servidor utilizado en la práctica, procesa de forma predeterminada el texto en lotes de 512 tokens, frente a los 2 048 de nuestra configuración de llama-bench.
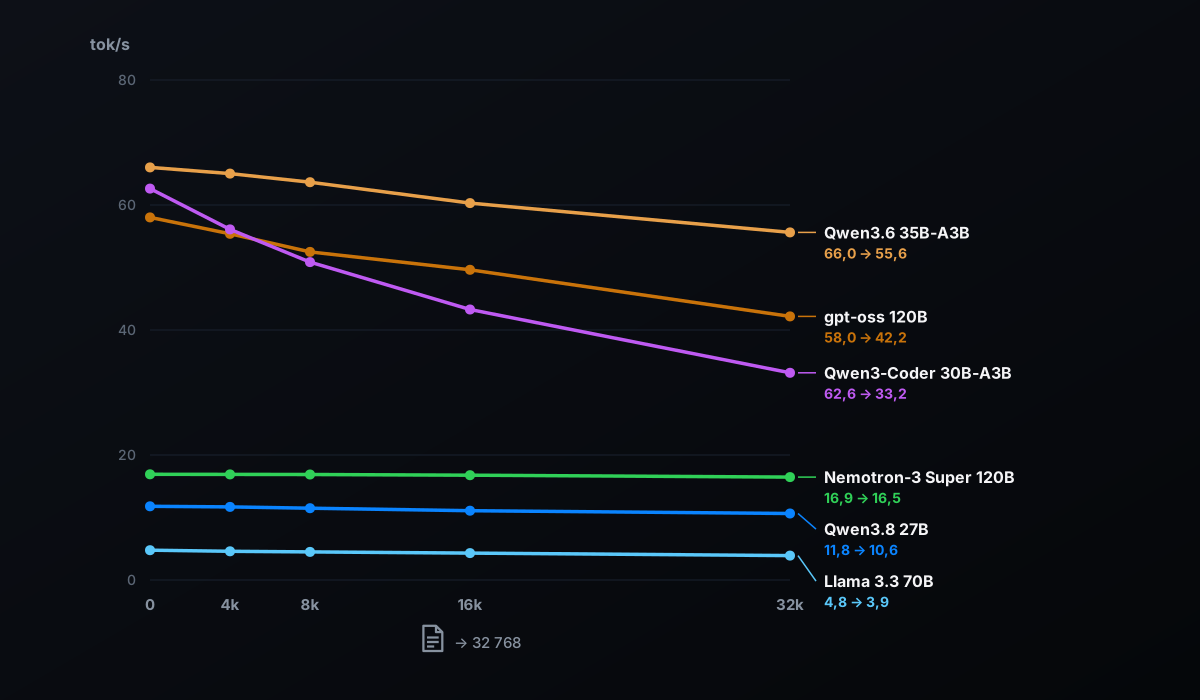
La lectura es un punto fuerte de la GB10: frente al Mac comparado más abajo, lee gpt-oss 120B un 31 % más rápido. Si depositas un informe de unas cincuenta páginas, la respuesta empieza 22 segundos después con gpt-oss 120B, y 1 min 44 s después con un 70B denso. Para el análisis de documentos y los agentes de código, este criterio pesa mucho.
#Hasta 16 usuarios al mismo tiempo: lo que soporta la máquina
Con vLLM, simulamos 1, 8 y después 16 usuarios simultáneos. Cada uno envía una solicitud de 1 024 tokens y recibe una respuesta de 512 tokens; cada punto se mide tres veces con solicitudes diferentes y publicamos la mediana.
| Modelo | Usuarios | Total | Por persona | Primera palabra (promedio) | Primera palabra (casos más lentos) |
|---|---|---|---|---|---|
| gpt-oss 120B | 1 | 35,6 tok/s | 36,4 tok/s | 0,34 s | 0,35 s |
| gpt-oss 120B | 8 | 113,9 tok/s | 14,5 tok/s | 0,97 s | 1,62 s |
| gpt-oss 120B | 16 | 160,3 tok/s | 10,2 tok/s | 1,07 s | 3,71 s |
| gpt-oss 20B | 1 | 49,1 tok/s | 50,0 tok/s | 0,16 s | 0,16 s |
| gpt-oss 20B | 8 | 205,9 tok/s | 26,5 tok/s | 0,49 s | 0,81 s |
| gpt-oss 20B | 16 | 322,4 tok/s | 20,7 tok/s | 0,52 s | 1,73 s |
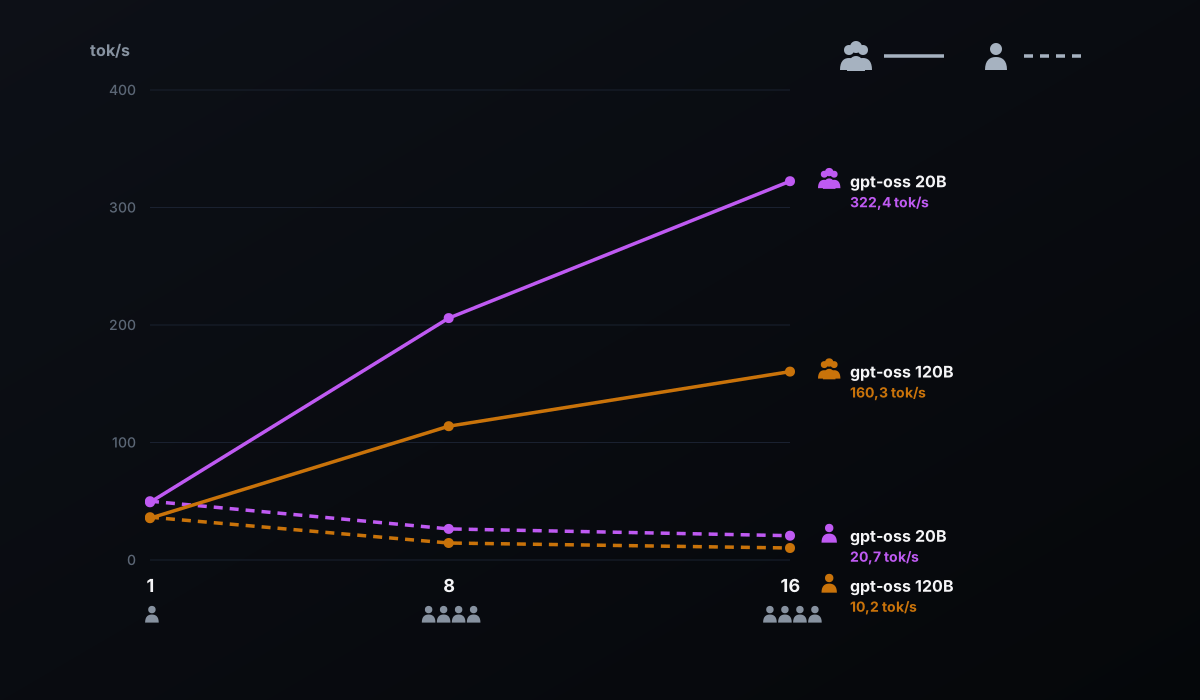
Entre 1 y 16 usuarios, el rendimiento total se multiplica por 4,5 con gpt-oss 120B y por 6,6 con gpt-oss 20B: cuando varias solicitudes comparten la lectura de los mismos pesos, el chip aprovecha plenamente su potencia de cálculo.
Con 16 personas, cada una sigue viendo cómo se escribe su respuesta a 10 tokens por segundo con gpt-oss 120B, y a 21 con gpt-oss 20B. Con el modelo de 120 mil millones, la primera palabra llega en algo más de un segundo de media, y en casi 4 segundos en los casos más lentos.
Para una sola persona, en cambio, vLLM no es el más rápido: sin ningún ajuste de rendimiento específico, escribe a 36,4 tokens por segundo en gpt-oss 120B, frente a los 54,4 de llama.cpp en respuestas largas. Sus registros muestran que en la GB10 elige el núcleo de cálculo Marlin para el formato MXFP4, lo que probablemente explica la diferencia. vLLM se justifica en cuanto varias personas o varios agentes comparten la máquina.
#A solas frente a la máquina: ¿Ollama o llama.cpp?
Ollama es la forma más sencilla de empezar y funciona en la GB10 sin ajustes. Sin embargo, en gpt-oss no es el más rápido. En respuestas largas, la versión 0.34.1 escribe a 42,3 tokens por segundo en gpt-oss 120B, frente a 54,4 de llama.cpp en el mismo formato MXFP4, es decir, un 22 % menos. En gpt-oss 20B: 58,8 frente a 78,8, es decir, un 25 % menos.
Con los modelos Qwen, ocurre lo contrario. En Qwen3.8 27B, Ollama escribe entre 22,9 y 30,5 tokens por segundo según el fragmento, frente a 11,8 con llama.cpp configurado de forma predeterminada; en Qwen3.6 35B-A3B, entre 90,5 y 94,9, frente a 66,0. La razón probable: Ollama activa de forma predeterminada una decodificación especulativa, que propone varios tokens por adelantado y el modelo valida de una vez (el ajuste draft_num_predict aparece en la configuración de estos modelos).
Nuestra prueba apunta en esa dirección. En llama-server (seis textos de 400 tokens, prosa y código), la decodificación especulativa de llama.cpp (MTP, que predice varios tokens a la vez) hace que Qwen3.8 27B pase de 11,7 a 21,5 tokens por segundo en prosa, y de 11,6 a 27,2 en código.
En la práctica: Ollama para empezar y para los modelos Qwen, que acelera de serie; llama.cpp para sacar el máximo partido a gpt-oss o a Qwen3.8 activando su decodificación especulativa. La mejor opción depende más de los ajustes que de la máquina.
#Frente al MacBook Pro M5 Max de 128 GB
Un lector midió su MacBook Pro M5 Max de 128 GB (GPU de 40 núcleos) el 16 de septiembre con Ollama 0.34.1, en una sola pasada por modelo; sus mediciones están publicadas en nuestra guía específica. Repetimos las mismas series en el ATOM, en dos pasadas: misma versión de Ollama, mismos modelos, mismo prompt.
| Medición | ATOM, 1.er paso | ATOM, 2.ª pasada | MacBook Pro M5 Max | Diferencia |
|---|---|---|---|---|
| Escritura, gemma4:12b | 45,9 | 54,1 | 58,1 | Mac +7 a +27 % |
| Escritura, qwen3.8:27b | 30,5 | 22,9 | 36,6 | Mac +20 a +59 % |
| Escritura, gpt-oss:20b | 58,1 | 58,8 | 113,4 | Mac +93 a +95 % |
| Escritura, gpt-oss:120b | 42,2 | 42,3 | 79,1 | Mac +87 % |
| Lectura, gpt-oss:120b | 1 816 | — | 1 388 | ATOM +31 % |
El Mac escribe más rápido en los cuatro modelos, casi el doble de rápido en los dos gpt-oss, cuyas pasadas coinciden: su chip dispone de 614 GB/s de ancho de banda, más del doble que la GB10. En gemma4 y qwen3.8, la diferencia varía de una pasada a otra; la decodificación especulativa, cuya ganancia depende del texto generado, es una posible explicación.
El ATOM lee más rápido, probablemente gracias a la potencia de cálculo de su GPU, con textos parecidos pero no idénticos (16 850 y 16 689 tokens). Con llama.cpp, la diferencia de escritura se reduce: 54,4 tokens por segundo en gpt-oss 120B, frente a 79,1 en el Mac con Ollama.
#Para quién es ATOM la opción adecuada
Lo que sigue procede de nuestras mediciones en el ATOM.
- ATOM es la opción adecuada si quieres modelos grandes en casa
- Cinco modelos de más de 100.000 millones de parámetros caben con margen. Hasta donde sabemos, ninguna tarjeta gráfica de consumo se acerca a esos 128 GB.
- … si trabajas con documentos largos o código
- 30 000 tokens leídos en 22 segundos con gpt-oss 120B.
- … si varias personas o agentes la comparten
- 160 tokens por segundo en total para 16 usuarios en gpt-oss 120B.
- … si quieres el ecosistema NVIDIA
- CUDA 13, vLLM en el contenedor de NVIDIA y llama.cpp compilado para el chip GB10 funcionaron en nuestro caso con DGX OS 7.5.0.
- Si estás solo y priorizas la velocidad de escritura
- Compáralo con el MacBook Pro M5 Max: gracias a sus 614 GB/s, escribe más rápido en gpt-oss, mientras que ATOM lee un documento largo un 31 % más rápido en gpt-oss 120B. Compara también los precios.
- Si tus modelos se mantienen por debajo de 35 GB
- La versión de 64 GB de ATOM, anunciada para el 23 de octubre de 2026, debería ser suficiente (cálculo basado en nuestras mediciones, no medido en esta versión).
#¿64 o 128 GB?
El 2 de octubre de 2026, NVIDIA anunció DGX Spark de 64 GB para modelos de hasta 100 mil millones de parámetros, disponibles el 23 de octubre en Acer, ASUS, Dell, GIGABYTE, HP y MSI, desde 4 999 dólares. GIGABYTE confirmó el 5 de octubre una AI TOP ATOM de 64 GB con el mismo diseño. No la hemos medido.
Nuestras mediciones permiten hacer un cálculo. Los modelos hasta Qwen3-Coder 30B-A3B ocupan menos de 35 GB con 32 768 tokens de contexto y cabrían; Llama 3.3 70B (51 GB) estaría en el límite. gpt-oss 120B (62 GB) y los modelos más grandes no cabrían. A igual ancho de banda, algo que habrá que comprobar, las velocidades deberían ser similares.
Para un modelo de más de 100 000 millones de parámetros en una sola máquina, la versión de 128 GB se impone. Según NVIDIA, dos máquinas de 64 GB conectadas también ponen su memoria en común; no lo hemos probado.
#Los precios registrados
El 8 de octubre de 2026, la versión de 4 TB en PCIe 4.0 (ATAGB10-9001, mismo chip GB10 y los mismos 128 GB) aparecía a 6 346,27 € con IVA incluido en la tienda oficial de AORUS, agotada; estaba disponible en Amazon.fr, vendida por Amazon UK (un ejemplar). La versión probada, de 4 TB en PCIe 5.0 (ATAGB10-9000), costaba 7 999,95 € en LDLC y en Materiel.net, agotada.
Los precios y las existencias de estas máquinas cambian rápido: compruébalos antes de comprar.
#Nuestro veredicto
La ATOM es una excelente opción para ejecutar en casa un modelo de 120 mil millones de parámetros, compartirlo con un equipo o leer rápidamente documentos largos. Nos proporcionó el rendimiento de referencia de la plataforma, sin ninguna limitación térmica señalada en nuestras mediciones, incluso durante una hora de carga continua con 16 usuarios. Si el presupuesto importa, su versión PCIe 4.0 conserva el mismo chip y la misma memoria.
#Lo que no hemos medido
- La calidad de las respuestas
- Esta guía mide qué funciona y a qué velocidad, no cuánto vale cada modelo.
- Las temperaturas, el ruido y el consumo
- La siguiente guía de la serie detalla las temperaturas bajo carga prolongada; el consumo tiene su propia guía, medido en el chip (solo GPU). Para el ruido, citamos las mediciones de Hardware & Co.
- Los contextos de más de 32 768 tokens
- Varios modelos aceptan contextos mucho más largos; esta guía se detiene en 32 768 tokens, y el tutorial 70B de la serie llega hasta 131 072 tokens para Llama 3.3 70B y gpt-oss 120B.
- Las otras máquinas GB10 y la versión de 64 GB
- Nuestros datos coinciden con los publicados para la DGX Spark de NVIDIA, pero solo hemos medido la ATOM de 128 GB.
Actualizaciones y correcciones: esta página se revisará si una nueva versión de DGX OS, llama.cpp o Ollama cambia estos resultados; cada corrección llevará fecha.
#FAQ
¿Cuál es el modelo más grande que se puede ejecutar en una máquina GB10 de 128 GB?+
¿Se puede usar a diario un modelo 70B en una GB10?+
¿Las velocidades de esta guía son válidas para una DGX Spark de NVIDIA o de otra marca?+
¿Hay que elegir la versión de 64 GB o 128 GB?+
¿Es Ollama la mejor opción en una máquina GB10?+
¿Un comentario, un error, una precisión? Avísanos, eso mejora la guía para todos.