LLM 70B en local en GB10: el tutorial complet
En una GIGABYTE AI TOP ATOM (chip NVIDIA GB10, 128 GB), Llama 3.3 70B cabe con margen: 43,6 GB con un contexto de 8 192 tokens, 82 GB con 131 072. Genera entre 4,6 y 5,3 tokens por segundo con tres vías: Ollama, llama.cpp o vLLM. Un borrador Llama 3.2 1B lleva llama.cpp a 12 tokens por segundo en prosa y 19 en código. Con ocho usuarios, vLLM mantiene 38,6 tokens por segundo en total de media durante dos horas.
Un modelo de 70 000 millones de parámetros como Llama 3.3 70B es «denso»: usa todos sus parámetros para escribir cada palabra y necesita mucha memoria. Los 128 GB de una máquina GB10 le dan cabida de sobra. Este tutorial ofrece los comandos de tres formas de instalarlo, probadas en una AI TOP ATOM cedida gratuitamente por GIGABYTE, y luego las mediciones que ayudan a elegir: velocidad, modelo borrador pequeño, memoria del contexto, estabilidad durante dos horas y servicio a varios usuarios.
#La máquina, el método y las unidades
Primero, algo de vocabulario. Un token es un fragmento de palabra: en francés, un token equivale aproximadamente a dos tercios de palabra. El contexto es el texto que el modelo mantiene en memoria durante un intercambio: tus preguntas, tus documentos y sus respuestas. La velocidad de escritura es el ritmo al que se muestra la respuesta, en tokens por segundo (tok/s). La velocidad de lectura es el ritmo al que la máquina absorbe tu texto antes de responder.
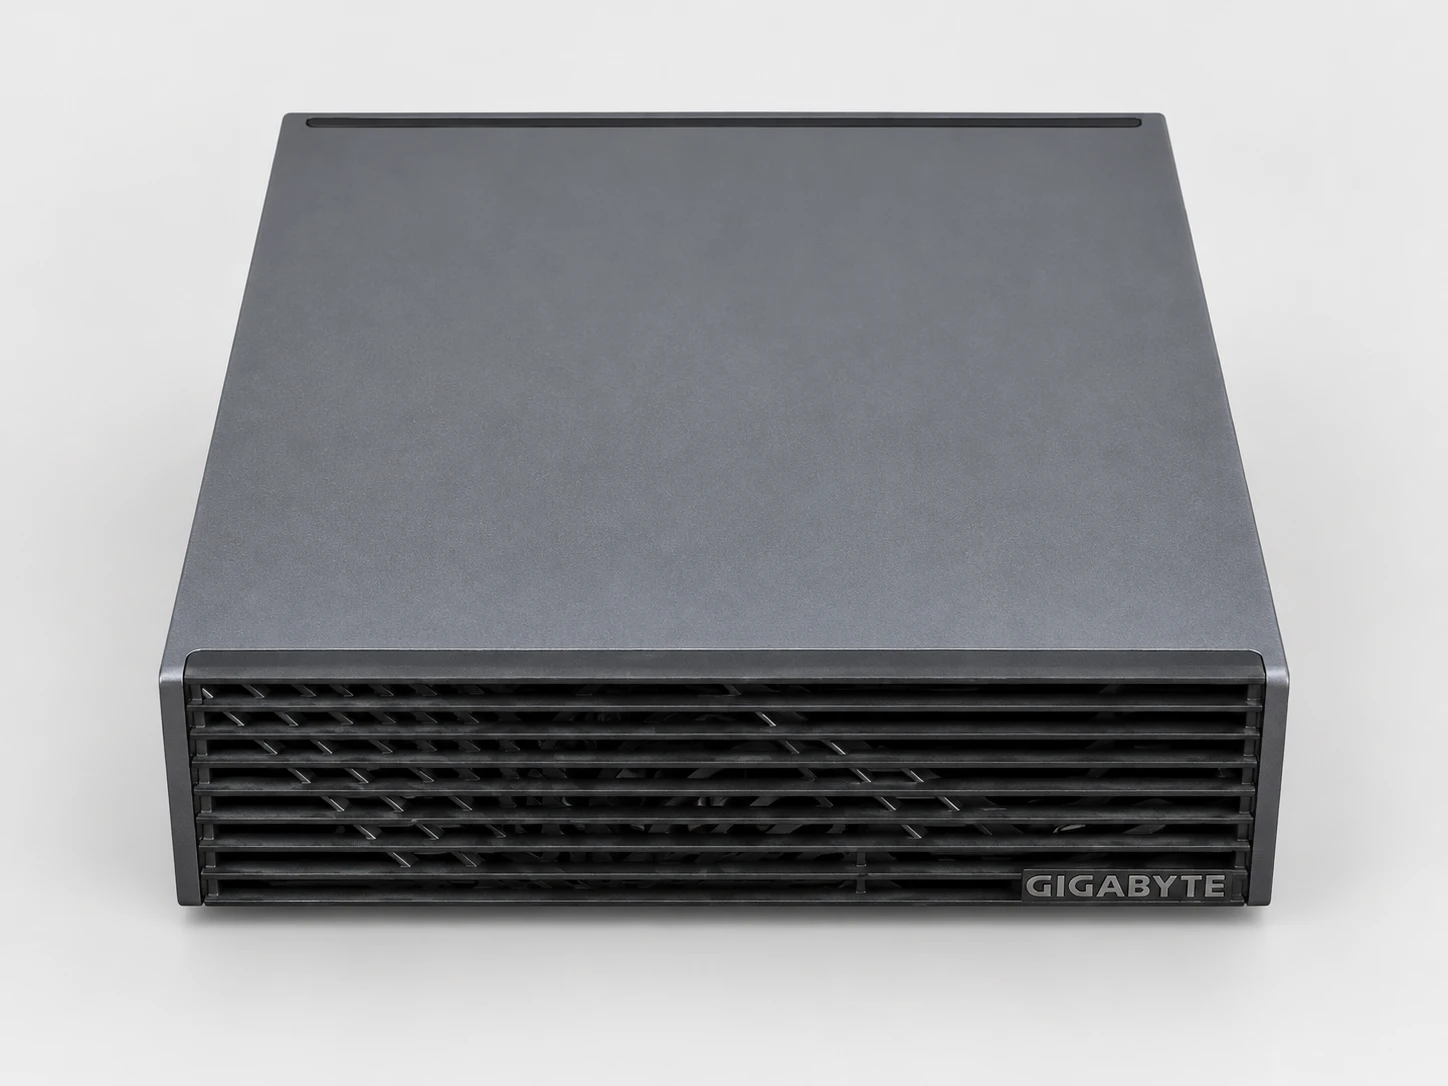
La máquina es una GIGABYTE AI TOP ATOM, referencia ATAGB10-9000. Su chip NVIDIA GB10 reúne 20 núcleos Arm y una GPU Blackwell, que comparten 128 GB de memoria a 273 GB/s. El SSD es de 4 TB PCIe 5.0. Funciona con DGX OS 7.5.0, el sistema de NVIDIA basado en Ubuntu (controlador 580.159.03, CUDA 13.0). El sistema ve 121,7 GB de memoria.
- Lo que proviene de la plataforma NVIDIA GB10
- El chip, sus 128 GB a 273 GB/s y DGX OS determinan las velocidades de esta guía. Al reproducir dos referencias publicadas para el DGX Spark de NVIDIA, con llama.cpp y con Ollama, nuestras velocidades difieren como máximo un 4,3 %. Hasta donde sabemos, deberían por tanto aplicarse a las demás máquinas GB10 de 128 GB. Las mediciones de esta guía se realizaron en la AI TOP ATOM.
- Lo que aporta GIGABYTE
- El chasis de aproximadamente un litro y su refrigeración, el acabado, las referencias (la 9000 lleva un SSD de 4 TB PCIe 5.0) y la garantía del distribuidor. Durante nuestras dos horas de servicio continuo, la GPU no superó los 72 °C y no apareció ninguna limitación térmica.
Las mediciones son del 6 y 7 de octubre de 2026 (el asistente privado con Open WebUI, del 7 y 8 de octubre). El protocolo se fijó el 6 de octubre a las 13:30, antes de la primera medición. Unos anexos fechados, redactados antes de las pruebas que describen, añadieron la decodificación especulativa y el presupuesto de memoria. El método y los datos de nuestras tablas están publicados en nuestra página de metodología.
Las velocidades de escritura de llama.cpp y de TensorRT-LLM provienen de seis textos de 400 tokens: tres en prosa en francés y tres solicitudes de código. Las de Ollama (un texto de 300 palabras) y de vLLM (solicitudes aleatorias de 1 024 tokens de entrada y 256 de salida) siguen los protocolos descritos en sus secciones. La temperatura se fija en 0: el modelo elige siempre la palabra más probable, lo que hace comparables las pruebas. Publicamos la mediana de los tres textos de cada tipo.
Los tamaños de memoria están en GB (1 GB = 1 024 MB, como lo muestra Linux); los anchos de banda en GB/s son los anunciados por los fabricantes, en unidades decimales. Las versiones utilizadas son llama.cpp b11430 (build del 5 de octubre de 2026), Ollama 0.34.1, vLLM 26.09 y TensorRT-LLM 1.3.0rc12, estas dos últimas en los contenedores de NVIDIA. Nuestra primera guía de la serie ofrece las mediciones de 13 modelos, entre ellos Llama 3.3 70B; esta muestra cómo instalarlo y acelerarlo.
#Vía 1: Ollama, la más sencilla
Ollama es la forma más sencilla de empezar: un archivo comprimido que descomprimir, un comando para descargar el modelo y otro para hablar con él. Instalamos la versión 0.34.1 a partir del archivo oficial para Linux Arm, en una carpeta y sin servicio del sistema. Si prefieres el instalador habitual, nuestra guía de instalación en Linux lo describe.
La opción --verbose hace que se muestren las estadísticas al final de la respuesta. En nuestras pruebas, Llama 3.3 70B (en Q4_K_M, una compresión de los pesos) escribe a 4,97 tok/s en la primera pasada y a 4,95 tok/s en la segunda. El comando ollama ps indica 85 GB cargados, en unidades decimales: Ollama abrió por sí solo un contexto de 131 072 tokens. Con un texto de 18 823 tokens, la lectura tarda 55,6 s, es decir, 338,7 tok/s, y la escritura posterior se mantiene en 4,38 tok/s.
Para situar estas cifras: Ollama publica 4,423 tok/s para Llama 3.1 70B Q4_K_M en un DGX Spark de NVIDIA (versión 0.12.6, 23 de octubre de 2025). Con la misma versión, el mismo script y el mismo modelo (Llama 3.1 70B), nuestro ATOM da 4,34 tok/s, con un 2 % de diferencia. Para reducir el contexto y la memoria ocupada, define la variable OLLAMA_CONTEXT_LENGTH antes de iniciar el servidor; no medimos esta variante.
#Vía 2: llama.cpp, la que ofrece más ajustes
llama.cpp es un motor de código abierto muy extendido. Lee los modelos en formato GGUF, un único archivo que contiene los pesos. Hay que compilarlo una vez para el chip GB10, pero da acceso a todos los ajustes: tamaño del contexto, formato de la caché del contexto, modelo borrador. La compilación sigue la guía de NVIDIA, con la arquitectura CUDA 121a-real, la de la GB10, pero sin libcurl (-DLLAMA_CURL=OFF) ni RPC.
El archivo elegido es Llama 3.3 70B en Q4_K_M, publicado por bartowski: 39,6 GB. Con la caché del disco vaciada, llama.cpp lo carga en 8 s desde el SSD. El comando hf proviene de la biblioteca huggingface_hub (instalación: pip install -U huggingface_hub). Si Hugging Face te pide aceptar la licencia Llama, acéptala en el sitio y luego inicia sesión con hf auth login.
- -ngl 99
- Coloca todas las capas del modelo en la GPU.
- -fa on
- Activa Flash Attention, que hace la lectura del contexto más eficiente.
- -lm dio
- Lee el archivo mediante acceso directo al disco, sin pasar por la caché del sistema (mmap). Es el modo de la tabla de referencia publicada por el proyecto llama.cpp para el DGX Spark.
- -c 16384 -np 1
- Un contexto de 16 384 tokens para un solo usuario. El contexto solicitado se reparte entre los usuarios simultáneos.
- --host 127.0.0.1
- El servidor solo es accesible desde la propia máquina.
Con nuestros seis textos, llama-server escribe a 4,70 tok/s en prosa y 4,62 en código. La herramienta de medición llama-bench da 4,8 tok/s en escritura (32 tokens) y 405 tok/s en lectura (2 048 tokens). El modelo ocupa 43,6 GB con un contexto de 8 192 tokens.
Como referencia, la memoria lee como máximo 273 mil millones de bytes por segundo, y cada token requiere volver a leer los pesos del modelo, es decir, 42,5 mil millones de bytes: el máximo teórico es de 6,4 tok/s, y la medición alcanza aproximadamente tres cuartas partes.
#Vía 3: vLLM en NVFP4, para varios usuarios
vLLM es un servidor diseñado para atender a varias personas a la vez. NVIDIA lo proporciona en un contenedor, es decir, un programa aislado que ejecuta Docker. El modelo es Llama 3.3 70B en NVFP4, un formato de 4 bits de NVIDIA que los chips Blackwell calculan directamente: ocupa 39,9 GB en memoria. La matriz de modelos compatibles de la guía de vLLM de NVIDIA para DGX Spark incluye este modelo.
Los ajustes --max-model-len 8192 y --max-num-seqs 16 limitan el contexto a 8 192 tokens y a 16 solicitudes procesadas a la vez. El ajuste --gpu-memory-utilization 0.85 fija la parte de la memoria que reserva vLLM: aquí 103 GB, de los cuales 59,6 GB son de caché. Esta caché mantiene a la vez 390 352 tokens, es decir, el equivalente a casi 48 solicitudes de 8 192 tokens simultáneas. El primer arranque tarda unos 7 minutos: 4 min 20 s para leer el modelo y luego unos 2 minutos de preparación.
Para un usuario, vLLM escribe a 5,3 tok/s (5,26, 5,27 y 5,26 en tres series) y la primera palabra llega en 0,73 s de media. Con ocho usuarios simultáneos, la máquina escribe 37,7 tok/s en total, incluida la espera de la primera palabra; una vez iniciada su respuesta, cada usuario recibe 5,0 tok/s.
La primera palabra llega en 2,8 s de media y en menos de 4,8 s en los casos más lentos. Las solicitudes de esta prueba tienen 1 024 tokens de entrada y 256 de salida; cada punto se mide tres veces.
#Las tres vías lado a lado
| Vía | Generación | Memoria | Ajustes | Recomendado para |
|---|---|---|---|---|
| Ollama 0.34.1 (Q4_K_M) | 4,95 | 85 GB mostrados por Ollama (en unidades decimales, es decir, unos 79 GB en el sentido de esta guía) con el contexto de 131 072 tokens que abre sin ajustes | peu | empezar rápido |
| llama.cpp b11430 (Q4_K_M) | 4,70 en prosa, 4,62 en código | 43,6 GB con 8 192 tokens, 51,3 GB con 32 768 | todos: contexto, caché, borrador | un usuario, con un borrador |
| vLLM 26.09 (NVFP4) | 5,3; 37,7 en total para 8 usuarios | 103 GB reservados con el ajuste 0,85 | los de un servidor | varios usuarios |
Las tres vías escriben a la misma velocidad, con menos de un 15 % de diferencia. La razón es sencilla: para cada token, el chip vuelve a leer los pesos del modelo, y es el ancho de banda de 273 GB/s lo que marca el ritmo de un modelo denso. Por eso, un 70B escribe a unos 5 tok/s, es decir, unas 200 palabras por minuto, el ritmo de una lectura pausada.
Este ritmo es adecuado para tareas sin prisa: resúmenes, extracciones, revisiones, borradores de respuestas. Para una conversación fluida existen dos palancas, presentadas en las secciones siguientes: el modelo borrador y un modelo MoE (mixture of experts) que solo usa una parte de sus parámetros en cada token.
#Acelerar un 70B con un pequeño modelo borrador
La decodificación especulativa usa un modelo pequeño, el borrador, que propone varias palabras por adelantado (más exactamente, tokens; decimos «palabras» para simplificar). El modelo grande verifica esas palabras en una sola pasada: cuesta más o menos lo mismo que escribir una sola, porque el tiempo se va sobre todo en la lectura de los pesos.
Las palabras correctas se conservan y las demás se descartan. El borrador no elige el texto: siempre es el modelo grande el que valida. NVIDIA describe el principio en su guía para DGX Spark, y el blog de LMSYS señala que esta técnica reduce en parte el límite de ancho de banda de la máquina.
#Con llama.cpp: un borrador Llama 3.2 1B
El borrador debe hablar el mismo idioma que el modelo grande, es decir, usar la misma tokenización. La familia Llama sirve: Llama 3.2 1B, en Q8_0, acompaña a Llama 3.3 70B. Bastan cuatro opciones: -md indica el borrador, --spec-type draft-simple elige el método, --spec-draft-n-max fija el número de tokens propuestos por adelantado (en esta guía los llamamos «palabras») y -ngld 99 coloca el borrador en la GPU.
| Configuración | Prosa en francés | Código | Aceptación (prosa / código) |
|---|---|---|---|
| 70B solo | 4,70 | 4,62 | — |
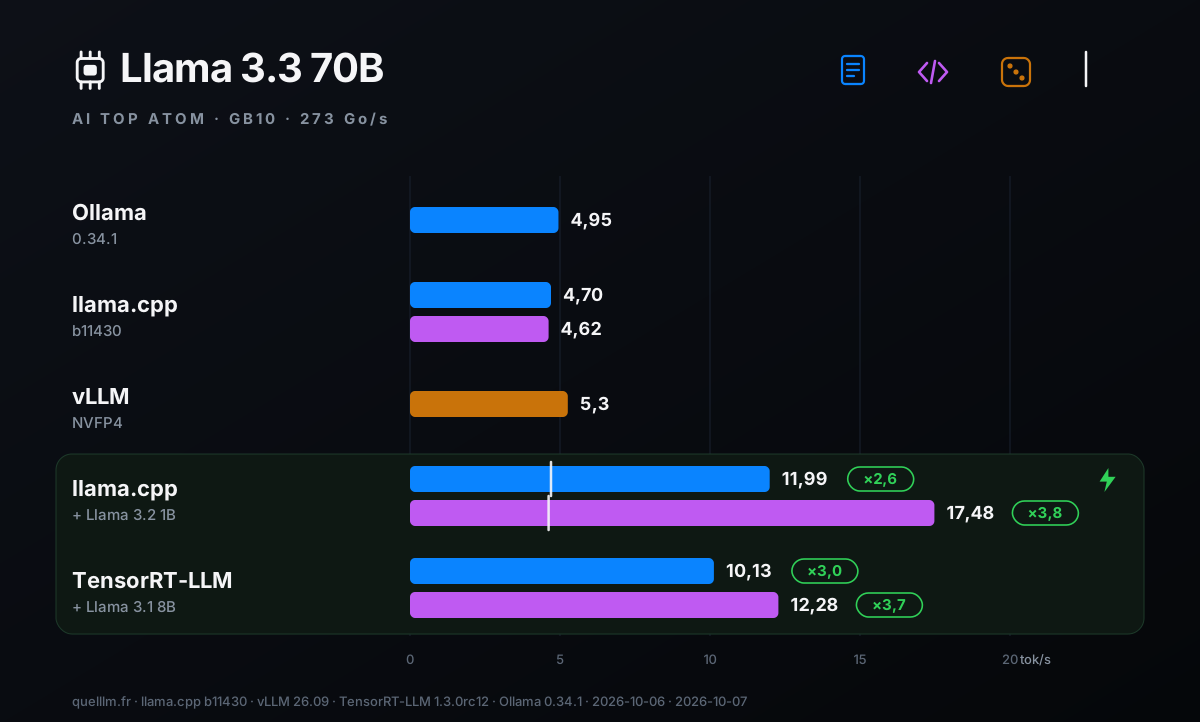
| + borrador Llama 3.2 1B, 8 palabras por adelantado | 11,99 (×2,6) | 17,48 (×3,8) | 33 % / 50 % |
| + borrador Llama 3.2 1B, 16 palabras por adelantado | 10,84 (×2,3) | 18,65 (×4,0) | 19 % / 34 % |
El borrador de 1 000 millones de parámetros hace que el 70B sea de 2,6 a 4 veces más rápido: 12 tok/s en prosa y hasta 19 tok/s en código. La ganancia depende del texto. En tres textos de código, la velocidad va de 13,2 a 18,0 tok/s con 8 palabras por adelantado. El borrador se acepta más a menudo en código (50 % de palabras conservadas) que en prosa (33 %).
Nuestros textos están en francés para la prosa y en inglés para el código; otros textos darán otras ganancias. Para la prosa, 8 palabras por adelantado funcionan mejor que 16 (11,99 frente a 10,84). Para el código, 16 dan algo más (18,65 frente a 17,48), con una diferencia entre textos del mismo orden. Empieza con 8.
El mismo principio existe sin un segundo archivo cuando el modelo incluye su propio módulo de predicción de varios tokens (MTP). Con Qwen3.8 27B y la opción --spec-type draft-mtp, llama.cpp pasa de 11,71 a 21,48 tok/s en prosa (×1,8) y de 11,59 a 27,23 tok/s en código (×2,3).
#Con TensorRT-LLM: la receta Draft-Target de NVIDIA
TensorRT-LLM es la biblioteca de NVIDIA para servir modelos de forma optimizada. Su guía para DGX Spark propone el método Draft-Target: Llama 3.3 70B en FP4 va acompañado de Llama 3.1 8B en FP4 como borrador. Ambos modelos los proporciona NVIDIA. En la versión 1.3.0rc12 del contenedor, el valor del ajuste se escribe Draft_Target, con guion bajo.
| Configuración | Prosa en francés | Código |
|---|---|---|
| + borrador Llama 3.1 8B FP4, 4 palabras de adelanto | 10,13 (×3,0 respecto al mismo motor sin borrador) | 12,28 (×3,7) |
Con TensorRT-LLM, el borrador multiplica la velocidad por 3,0 en prosa y por 3,7 en código, en comparación con el mismo motor sin borrador: el 70B escribe entonces 10,1 tokens por segundo en prosa y 12,3 en código.
Así pues, las dos vías, llama.cpp y TensorRT-LLM, aportan una mejora del mismo orden, de 2,6 a 4 veces. Para un solo usuario, llama.cpp sigue siendo la más sencilla: un archivo de borrador y cuatro opciones. TensorRT-LLM es la vía a seguir si quieres la receta oficial de NVIDIA, con modelos FP4 proporcionados por NVIDIA.
#El presupuesto de memoria del contexto, de 8 192 a 131 072 tokens
El contexto tiene un coste en memoria: la caché KV. Es la memoria donde el modelo guarda lo que ya ha leído, para no volver a calcularlo. Crece con la longitud del contexto. llama.cpp reserva toda esta caché desde la carga, así que la memoria ocupada tras la carga ya es la memoria final.
La medimos por la disminución de la memoria disponible (MemAvailable de Linux), después de vaciar la caché del disco. La opción -ctk q8_0 -ctv q8_0 guarda la caché en 8 bits en lugar de 16 (f16), lo que la aligera. En las tablas y los gráficos, 8k designa un contexto de 8 192 tokens, 32k de 32 768, 64k de 65 536 y 128k de 131 072.
| Modelo | Cache | 8 192 | 32 768 | 65 536 | 131 072 |
|---|---|---|---|---|---|
| Llama 3.3 70B Q4_K_M | f16 | 43,6 | 51,3 | 61,4 | 81,9 |
| Llama 3.3 70B Q4_K_M | q8_0 | 42,3 | 46,4 | 52,2 | 63,1 |
| gpt-oss 120B MXFP4 | f16 | 61,0 | 61,9 | 63,0 | 65,6 |
| gpt-oss 120B MXFP4 | q8_0 | 60,7 | 61,3 | 62,1 | 63,2 |
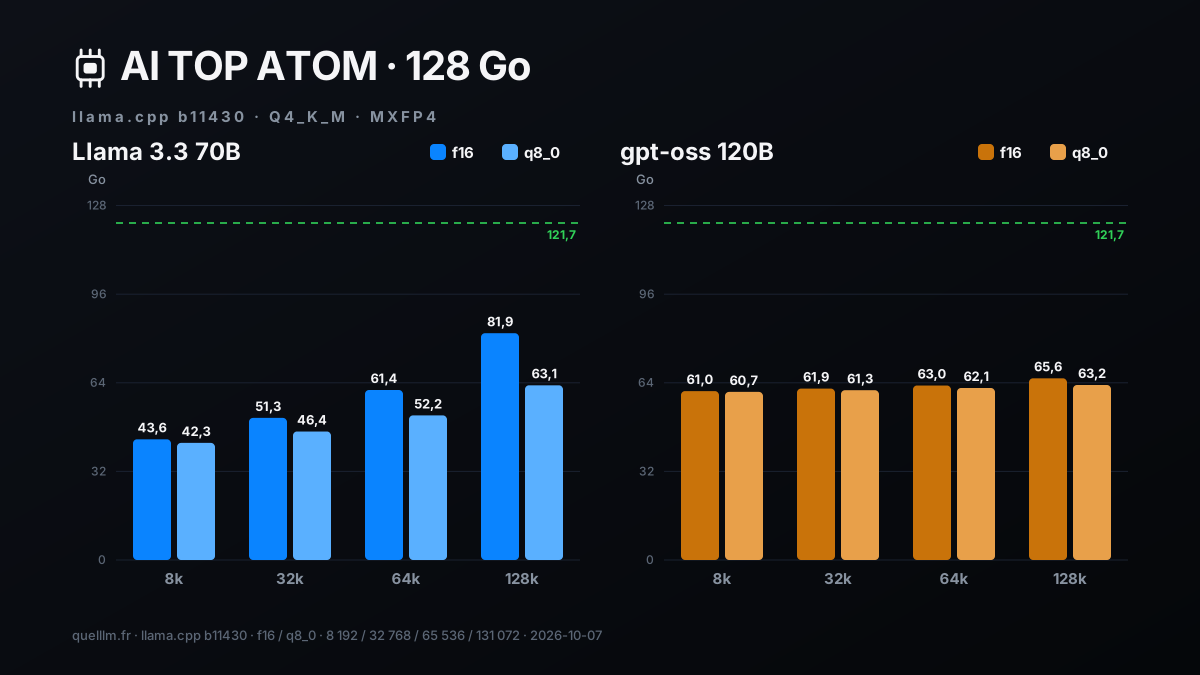
Todo cabe en los 121,7 GB, incluso el 70B con un contexto de 131 072 tokens en f16: 81,9 GB. El contexto añade 38 GB al 70B entre 8k y 128k en f16, y 21 GB en q8_0, es decir, casi la mitad. gpt-oss 120B solo añade 4,6 GB: alterna capas que miran todo el texto y capas que solo miran una ventana corta. El formato q8_0 se paga con una velocidad algo menor, de un 9 a un 11 % con 128k para el 70B (tabla siguiente).
También llenamos el contexto al 90 % con fichas prácticas de Service-Public, para medir la lectura y la escritura con el contexto lleno. A 128k, el texto tiene 117 605 tokens para el 70B y 117 889 para gpt-oss 120B, es decir, unas 200 páginas.
| Modelo | Cache | Texto leído (tokens) | Memoria (GB) | Lecture | Generación |
|---|---|---|---|---|---|
| Llama 3.3 70B | f16 | 29 214 (32k) | 51,4 | 286,1 (102 s) | 4,22 |
| Llama 3.3 70B | q8_0 | 29 214 (32k) | 46,5 | 271,1 (108 s) | 4,02 |
| Llama 3.3 70B | f16 | 117 605 (128k) | 82,0 | 181,9 (646 s) | 2,86 |
| Llama 3.3 70B | q8_0 | 117 605 (128k) | 63,2 | 164,6 (715 s) | 2,54 |
| gpt-oss 120B | f16 | 29 227 (32k) | 61,7 | 1 443 (20 s) | 43,81 |
| gpt-oss 120B | q8_0 | 29 227 (32k) | 61,2 | 1 401 (21 s) | 43,96 |
| gpt-oss 120B | f16 | 117 889 (128k) | 65,4 | 1 073 (110 s) | 26,93 |
| gpt-oss 120B | q8_0 | 117 889 (128k) | 63,4 | 993 (119 s) | 24,97 |
Todo funciona con el contexto lleno. gpt-oss 120B lee un texto de 200 páginas en 110 segundos y sigue generando a casi 27 tok/s. El 70B lee los 117 605 tokens a 182 tok/s. Para documentos muy largos, un modelo MoE es más rápido, tanto en lectura como en generación.
#Dos horas de servicio con ocho usuarios
Un servidor debe aguantar en el tiempo. Iniciamos vLLM 26.09 con Llama 3.3 70B en NVFP4 y enviamos solicitudes durante dos horas: ocho usuarios de forma continua, en lotes de 32 solicitudes de 1 024 tokens de entrada y 256 de salida. Un registro del chip, con una medición por segundo, siguió la potencia, la frecuencia y la temperatura de la GPU.
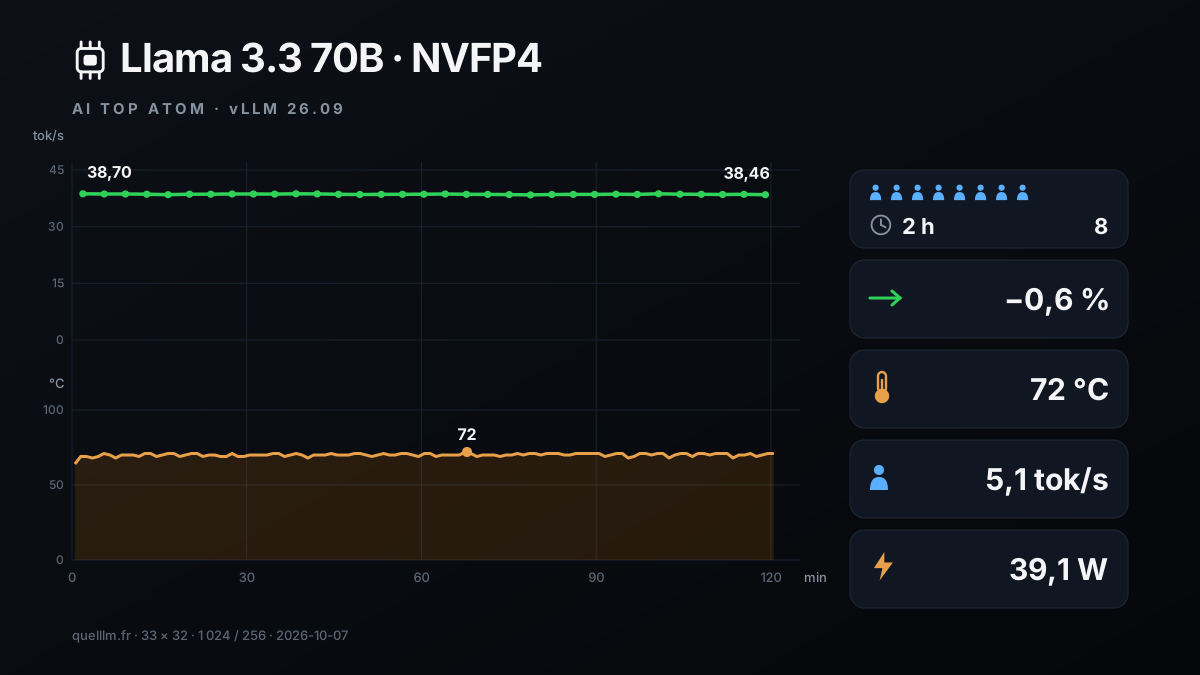
El resultado es sencillo: la velocidad no varió. El rendimiento total va de 38,70 tok/s en el primer tramo a 38,46 en el último, con un mínimo de 38,40 y un máximo de 38,70: la diferencia es de −0,6 %. Cada usuario recibe 5,1 tok/s. La primera palabra llega en 2,8 s de mediana, entre 2,4 y 2,9 s según el tramo.
En total, la máquina atendió 1 056 solicitudes, leyó 1 081 344 tokens y escribió 270 336 tokens, sin ningún error. La GPU se mantuvo a 72 °C como máximo. Su frecuencia mediana fue de 2 528 MHz y no se registró ningún motivo de limitación durante las dos horas de medición.
La potencia media de la GPU fue de 39,1 W, con un pico de 95,0 W. Estos vatios son los de la GPU, leídos por el chip: no incluyen ni el procesador, ni la memoria, ni el SSD, ni la fuente de alimentación. Las dos horas suponen 78,8 Wh para la GPU, es decir, 1,6 céntimos con la tarifa EDF Tarif Bleu Base (6 kVA), a 20,01 céntimos el kWh.
#Convertirlo en un servidor: API OpenAI, clave y Open WebUI
Una API OpenAI es un formato de solicitudes que muchas herramientas saben hablar: editores de código, interfaces de chat, scripts. llama-server y vLLM la ofrecen los dos. Para protegerla, llama-server acepta una clave con la opción --api-key: sin clave, responde con un error 401. Validamos estas tres llamadas con gpt-oss 20B; para el 70B, es el mismo comando con otro archivo.
La primera llamada devuelve 401, la segunda la lista de modelos servidos y la tercera una respuesta en formato OpenAI. La opción --jinja aplica la plantilla de conversación incluida en el archivo del modelo.
Para una interfaz de chat, Open WebUI se conecta a esta API. Esta es la pila de nuestra prueba de asistente privado (otra guía de la serie), con gpt-oss 120B. El servidor del modelo está en una red Docker interna, sin acceso a Internet. Open WebUI 0.11.4 está conectado a esa red y a una red de acceso.
Así, el modelo no tiene ninguna salida al exterior. El servidor no tiene clave, porque solo la red interna puede acceder a él; el valor local de OPENAI_API_KEY solo sirve para satisfacer a Open WebUI. Para servir el 70B en su lugar, sustituye la ruta del archivo por la de Llama-3.3-70B-Instruct-Q4_K_M.gguf y adapta -c y -np al presupuesto de memoria visto más arriba.
Después abre http://127.0.0.1:3100 en un navegador de la máquina: el modelo aparece en la lista. En nuestra prueba de asistente privado, la pila completa, con un servidor de embeddings (bge-m3) adicional, estaba lista en 66 segundos. Según la guía de llama.cpp de NVIDIA, Open WebUI, Continue.dev y otros clientes se conectan a esta API, que sigue el formato de la API de OpenAI (dirección del servidor seguida de /v1).
#La alternativa rápida: un modelo MoE de 120B
Un modelo MoE (mixture of experts) contiene muchos parámetros, pero solo usa una fracción de ellos en cada token. gpt-oss 120B tiene 117 mil millones de parámetros, de los cuales 5,1 mil millones están activos, y OpenAI lo publica directamente en formato MXFP4.
En la GB10, escribe a 58,0 tok/s con la herramienta de medición llama-bench (escritura de 32 tokens), y a 54,4 tok/s en respuestas largas en llama-server, tanto en prosa como en código. Es más de 11 veces la velocidad del 70B denso, con una memoria ocupada de 61,0 GB a 8 192 tokens y de 65,6 GB a 131 072.
La velocidad no dice nada de la calidad: no hemos comparado las respuestas de los dos modelos. Así puedes elegir. Elige gpt-oss 120B para conversación, agentes y documentos largos, donde la velocidad importa. Elige Llama 3.3 70B si necesitas ese modelo concreto, por ejemplo un modelo ajustado a partir de él, o para procesamientos por lotes en los que 5 tok/s bastan. Las mediciones de los 13 modelos, del 4B al 235B, están en nuestra primera guía de la serie.
#Lo que esta guía no mide
- La calidad de las respuestas
- Medimos la velocidad y la memoria, no lo que vale cada modelo.
- Las ganancias del borrador en otros textos
- Nuestros seis textos están en francés para la prosa y en inglés para el código. Las mejoras dependen del texto y del idioma.
- Los contextos de más de 131 072 tokens
- No medimos ni su memoria ni su velocidad.
- Las otras máquinas GB10 y la versión de 64 GB
- Nuestras mediciones en la ATOM de 128 GB coinciden con las referencias publicadas para el DGX Spark.
- El consumo de la máquina completa
- Los vatios indicados son los de la GPU, leídos por el chip.
Actualizaciones y correcciones: esta página se revisará si una nueva versión de DGX OS, llama.cpp, Ollama, vLLM o TensorRT-LLM cambia estos resultados; cada corrección llevará fecha.
#Para quién es ATOM la opción adecuada
Lo que sigue procede de nuestras mediciones en la ATOM, una máquina GB10 de 128 GB.
- La ATOM es la opción adecuada si quieres un modelo de 70 000 millones de parámetros en casa
- Cabe con margen: de 43,6 a 82 GB de 121,7 GB, con un contexto de 8 192 a 131 072 tokens, y funcionan tres vías de instalación.
- … si varias personas o agentes comparten el modelo
- Ocho usuarios obtienen 37,7 tok/s en total en una serie corta, y 38,6 tok/s de media durante dos horas, sin ningún error.
- … si quieres ir más rápido sin cambiar de máquina
- Un pequeño borrador multiplica la velocidad del 70B por 2,6 a 4, con llama.cpp o con la receta de NVIDIA.
- … si quieres una conversación rápida o documentos largos
- gpt-oss 120B escribe a 54,4 tok/s y lee 200 páginas en 110 segundos.
- … si tu trabajo pasa por el ecosistema NVIDIA
- CUDA 13, vLLM y TensorRT-LLM en los contenedores de NVIDIA y llama.cpp compilado para la GB10 funcionaron en nuestras pruebas con DGX OS 7.5.0.
En cuanto a GIGABYTE, el chasis de aproximadamente un litro mantuvo la GPU a 72 °C como máximo durante dos horas de carga continua, sin throttling. Los precios de las máquinas GB10 cambian cada semana: compruébalos en la ficha de la máquina antes de comprar.
#FAQ
¿Se puede ejecutar un modelo 70B en una máquina GB10 de 128 GB?+
¿A qué velocidad genera un 70B en el AI TOP ATOM?+
¿Conviene elegir Ollama, llama.cpp o vLLM?+
¿Cómo hacer que un 70B sea más rápido sin cambiar de máquina?+
¿Puede un 70B atender a varias personas durante horas?+
¿Es mejor un modelo MoE de 120B que un 70B denso?+
¿Un comentario, un error, una precisión? Avísanos, eso mejora la guía para todos.