GB10, Ryzen AI Max+ 395 o Mac: ¿quién va más rápido?
Con el mismo motor (llama.cpp), el AI TOP ATOM, con su chip NVIDIA GB10, lee los prompts entre 2,1 y 2,8 veces más rápido que el Ryzen AI Max+ 395 y un 23 % más rápido que el Mac M5 Max en el modelo de referencia publicado. En escritura, está al nivel del Ryzen (entre un 4 y un 15 % por delante según el modelo). El Mac M5 Max escribe aproximadamente el doble de rápido en un modelo denso pequeño: 119,9 frente a 59,4 tok/s (tokens por segundo).
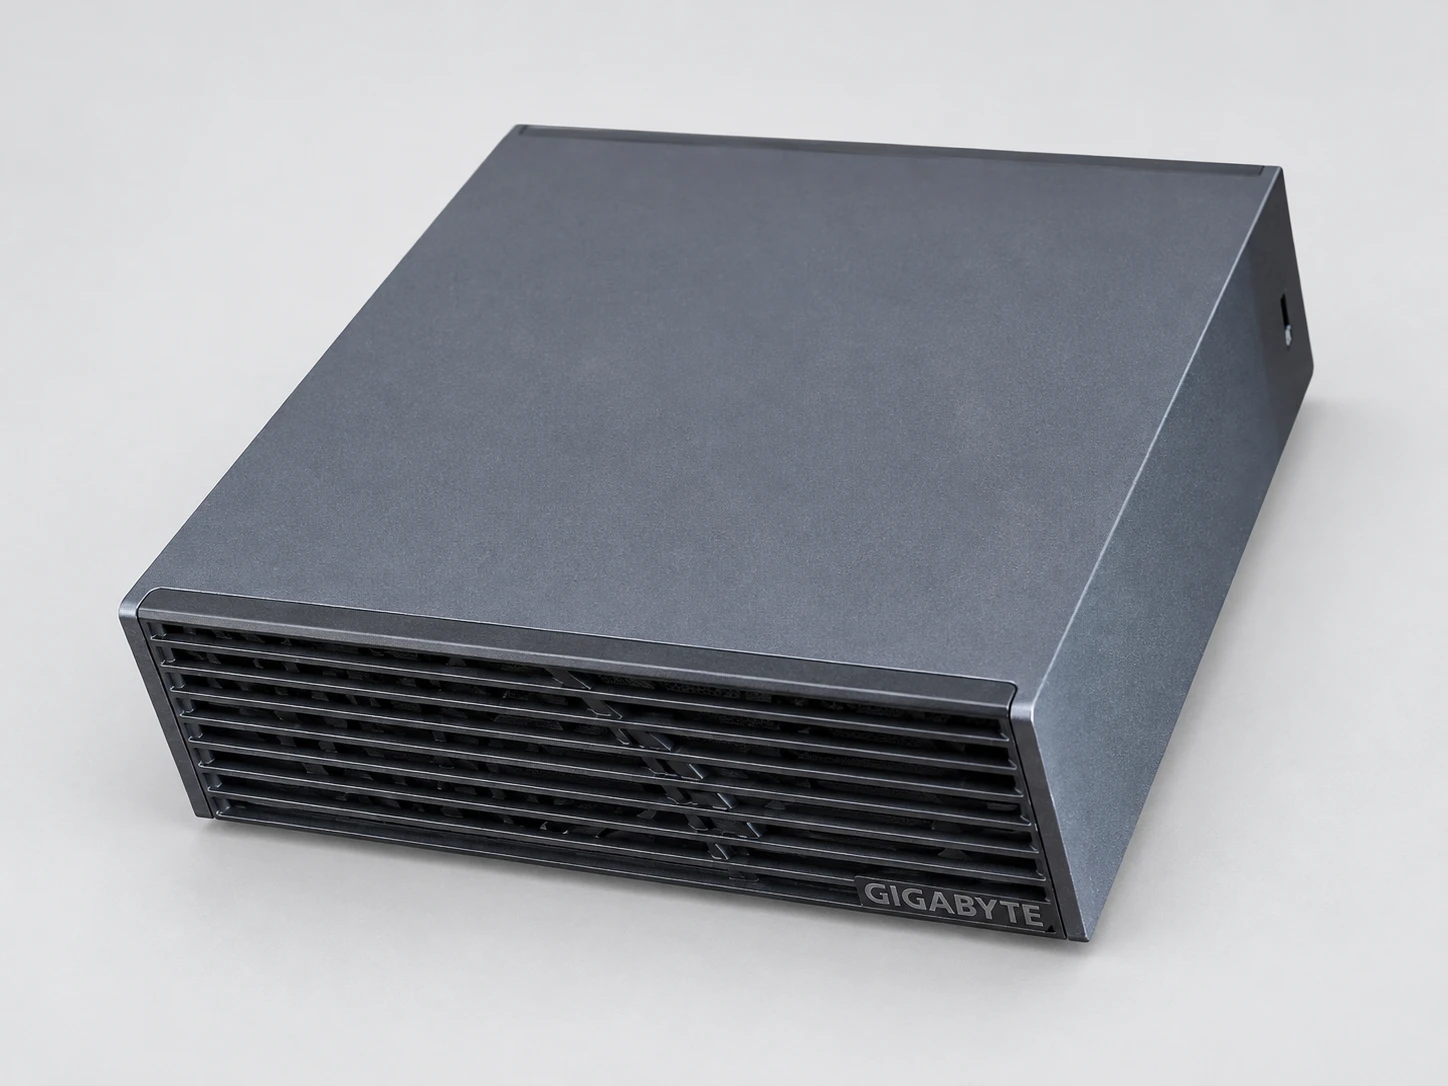
Tres familias de máquinas ofrecen 128 GB de memoria para IA local: el GB10 de NVIDIA, del que el AI TOP ATOM de GIGABYTE es una versión, el Ryzen AI Max+ 395 de AMD (nombre en clave Strix Halo) y el Mac M5 Max de Apple. Medimos nuestro AI TOP ATOM, cedido amablemente por GIGABYTE, con los mismos comandos que las mediciones publicadas para los otros dos, indicando la versión del software y la fecha. Aquí verás en qué destaca cada una y qué compra conviene para cada uso.
#¿Cómo comparamos tres máquinas?
Para comparar las referencias publicadas del Ryzen AI Max+ 395 y del Mac con las mediciones del ATOM, retomamos el formato exacto de mediciones ya publicadas. La primera prueba hace que la máquina lea 512 tokens (un token es un fragmento de palabra) y luego escriba 128 («pp512» y «tg128» en llama-bench, la herramienta de medición de llama.cpp, un motor de código abierto muy extendido para modelos locales).
Esta prueba se publicó para un Mac M5 Max en la discusión n.º 4167 de llama.cpp, y kyuz0, un colaborador independiente, la publicó para un Framework Desktop equipado con el Ryzen AI Max+ 395 y 128 GB. La segunda prueba mide la velocidad cuando ya hay 32 768 tokens en memoria. Es la de la discusión n.º 16578 de llama.cpp, y kyuz0 también la publica para el Ryzen.
Nuestro protocolo quedó fijado el 6 de octubre de 2026 a las 13:30, antes de la primera medición. Un anexo del mismo día, a las 23:45, añadió este formato de comparación.
Las mediciones de lectura a 512 tokens y de escritura a 128 tokens son del 7 de octubre a las 22:38: cinco repeticiones por modelo, llama.cpp build 11430, atención rápida (Flash Attention) activada como en las mediciones de kyuz0 y la máquina sin ninguna otra tarea en curso. Las mediciones a 32 768 tokens son del 6 de octubre. El método, los hashes de los archivos y los datos de nuestras tablas están publicados en nuestra página de metodología.
Las velocidades están en tokens por segundo (tok/s). Un token es un fragmento de palabra: en francés, equivale a unos dos tercios de palabra. Los tamaños de memoria están en GB (1 GB = 1 024 MB, como lo muestra Linux); los anchos de banda de memoria en GB/s son los anunciados por los fabricantes, en unidades decimales. Estos son los comandos usados en el ATOM:
Una advertencia: el build es el número de versión de llama.cpp, y las tres máquinas no usan el mismo. El Ryzen se midió con los builds b9187 o b9193 en mayo de 2026, el Mac con el b10621 en agosto y el ATOM con el b11430 en octubre.
Un build más reciente puede ir más rápido. Para ser honestos, también damos, para la prueba a 32 768 tokens, nuestras cifras con el build 7941 de febrero de 2026, más antiguo que el del Ryzen (no hay ninguna medición publicada para el Mac en este formato).
#Tres máquinas con 128 GB: ¿qué cambia?
Aprovecha nuestra experiencia y un recorrido guiado para elegir las herramientas adecuadas para tu Mac y usar tu IA en el día a día.
- Espacio en línea de por vida
- PDF + archivos
- Reembolsado 30 d
El GB10 de NVIDIA reúne 20 núcleos Arm y una GPU Blackwell en torno a 128 GB de memoria unificada (compartida por el procesador y la GPU), con un ancho de banda anunciado de 273 GB/s. El Ryzen AI Max+ 395 de AMD (nombre en clave Strix Halo) también comparte 128 GB entre el procesador y la GPU, con unos 256 GB/s en teoría. El M5 Max de Apple llega hasta 128 GB, con 614 GB/s y una GPU de 40 núcleos.
| Máquina | Chip | Memoria | Ancho de banda |
|---|---|---|---|
| AI TOP ATOM (GIGABYTE) | NVIDIA GB10: 20 núcleos Arm y GPU Blackwell | 128 GB LPDDR5x | 273 GB/s |
| Ryzen AI Max+ 395 (cifras publicadas en un Framework Desktop) | AMD Strix Halo | 128 GB LPDDR5x | unos 256 GB/s (teórico) |
| Mac M5 Max | Apple M5 Max: GPU de 40 núcleos | hasta 128 GB | 614 GB/s |
Para escribir cada token, el chip vuelve a leer de la memoria los pesos activos del modelo (los parámetros que se usan en ese momento): por eso la escritura depende del ancho de banda, y la lectura, que procesa muchos tokens a la vez, de la potencia de cálculo de la GPU.
El GB10 y el Ryzen tienen un ancho de banda parecido, y sus velocidades de escritura también lo son. El M5 Max ofrece 2,25 veces el ancho de banda del ATOM (614 frente a 273 GB/s): en el único modelo denso publicado, llama 7B, escribe aproximadamente el doble de rápido.
Hasta donde sabemos, todas las máquinas GB10 de 128 GB comparten el mismo chip NVIDIA. Por eso, las velocidades de esta guía son las de la plataforma. Lo que GIGABYTE aporta además es el chasis de un litro (1,2 kg), la refrigeración, los acabados y las referencias comerciales.
Para comprobar que nuestra unidad ofrece realmente las velocidades de la plataforma, reprodujimos la tabla publicada por el proyecto llama.cpp para el DGX Spark de NVIDIA, la máquina de referencia de la plataforma (build 7941, febrero de 2026). En seis modelos y 60 puntos de medición, nuestras lecturas están a +0,3 % de mediana (de −1,8 % a +2,3 %) y nuestras escrituras a −2,8 % de mediana (de −4,3 % a −0,3 %): las dos máquinas están al mismo nivel.
#¿Quién lee más rápido?
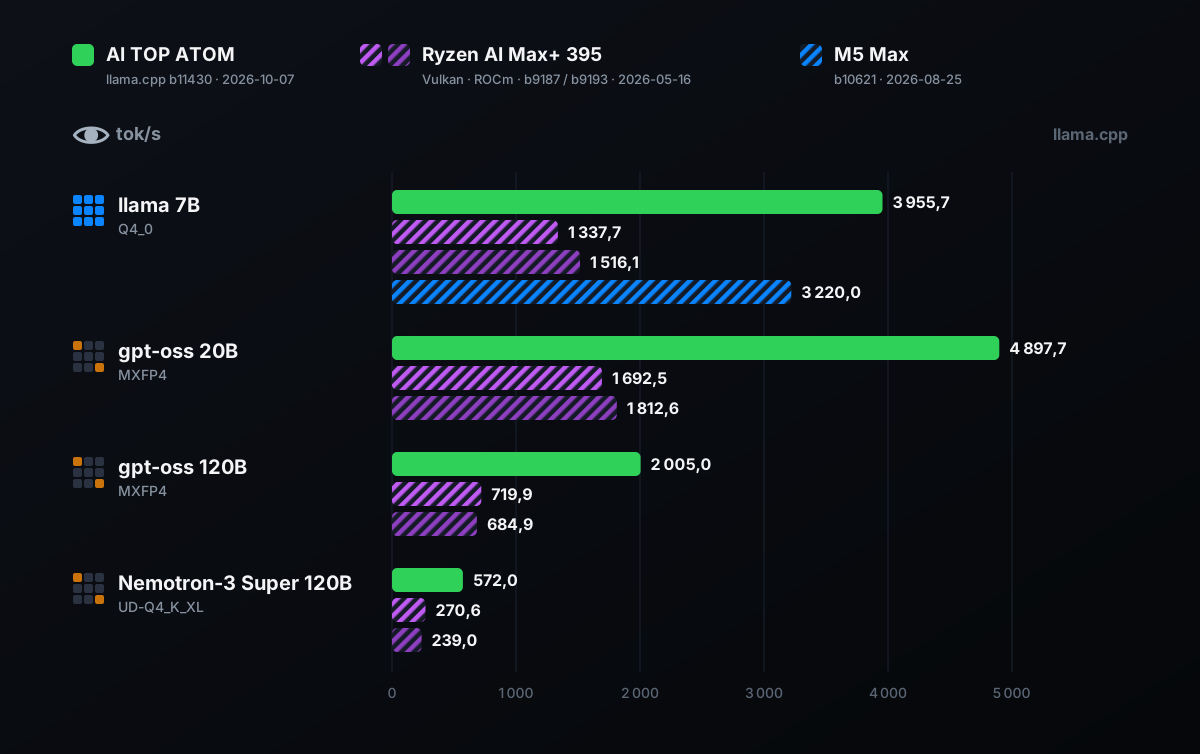
La lectura es el punto fuerte del ATOM. La tabla recoge los cuatro modelos que pudimos comparar de forma exacta, es decir, con el mismo modelo y la misma compresión en cada máquina. «llama 7B» designa Llama 2 de 7 mil millones de parámetros, el modelo de referencia de estas publicaciones: es un modelo denso (usa todos sus parámetros en cada token), mientras que los otros tres son modelos MoE (solo activan una parte de ellos).
| Modelo | AI TOP ATOM | Ryzen, Vulkan | Ryzen, ROCm | Mac M5 Max | ATOM / mejor Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 3 955,7 | 1 337,7 | 1 516,1 | 3 220,0 | × 2,6 |
| gpt-oss 20B (MXFP4) | 4 897,7 | 1 692,5 | 1 812,6 | — | × 2,7 |
| gpt-oss 120B (MXFP4) | 2 005,0 | 719,9 | 684,9 | — | × 2,8 |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 572,0 | 270,6 | 239,0 | — | × 2,1 |
En estos cuatro modelos, el ATOM lee de 2,1 a 2,8 veces más rápido que la mejor de las dos pilas de software del Ryzen AI Max+ 395 (Vulkan y ROCm son dos formas de poner a calcular la GPU de AMD). En gpt-oss 120B, lee 2 005 tokens por segundo: un prompt de 2 000 tokens, es decir, unas 1 300 palabras, se procesa en un segundo.
Frente al Mac, solo tenemos un punto de comparación publicado en formato llama-bench: el modelo de referencia de la discusión n.º 4167 de llama.cpp sobre los chips Apple, llama 7B (Llama 2 de 7 mil millones de parámetros) en Q4_0. Ahí el ATOM lee 3 955,7 tokens por segundo, frente a 3 220,0 del M5 Max: un 23 % más.
Con Ollama (una herramienta que ejecuta modelos en local), en un documento de unos 17 000 tokens, nuestra primera guía de la serie mide 1 816 tok/s en gpt-oss 120B para el ATOM, frente a 1 388 de un MacBook Pro M5 Max medido por un lector, con un texto parecido pero no idéntico (16 850 tokens para el ATOM, 16 689 para el Mac): un 31 % más.
¿Por qué lee tan rápido el ATOM? La lectura es sobre todo cálculo, y la GPU Blackwell del GB10 tiene núcleos dedicados a los cálculos de IA (los «Tensor Cores» de NVIDIA). Es el criterio que importa para un informe de cincuenta páginas, un repositorio de código o un agente que relee su historial antes de cada respuesta.
Dos precauciones al interpretar los datos. Primero, los builds son distintos (10621 para el Mac, 11430 para el ATOM): toma la diferencia del 23 % como un orden de magnitud. Segundo, los dos modelos más pequeños (llama 7B y gpt-oss 20B) varían de un 3 a un 5 % de una repetición a otra, porque esta prueba dura alrededor de una décima de segundo. Aun así, dos series distintas dan medias con una diferencia máxima del 1 %: 3 955,7 y 3 920,2 para llama 7B, 4 897,7 y 4 905,2 para gpt-oss 20B.
#¿Quién escribe más rápido?
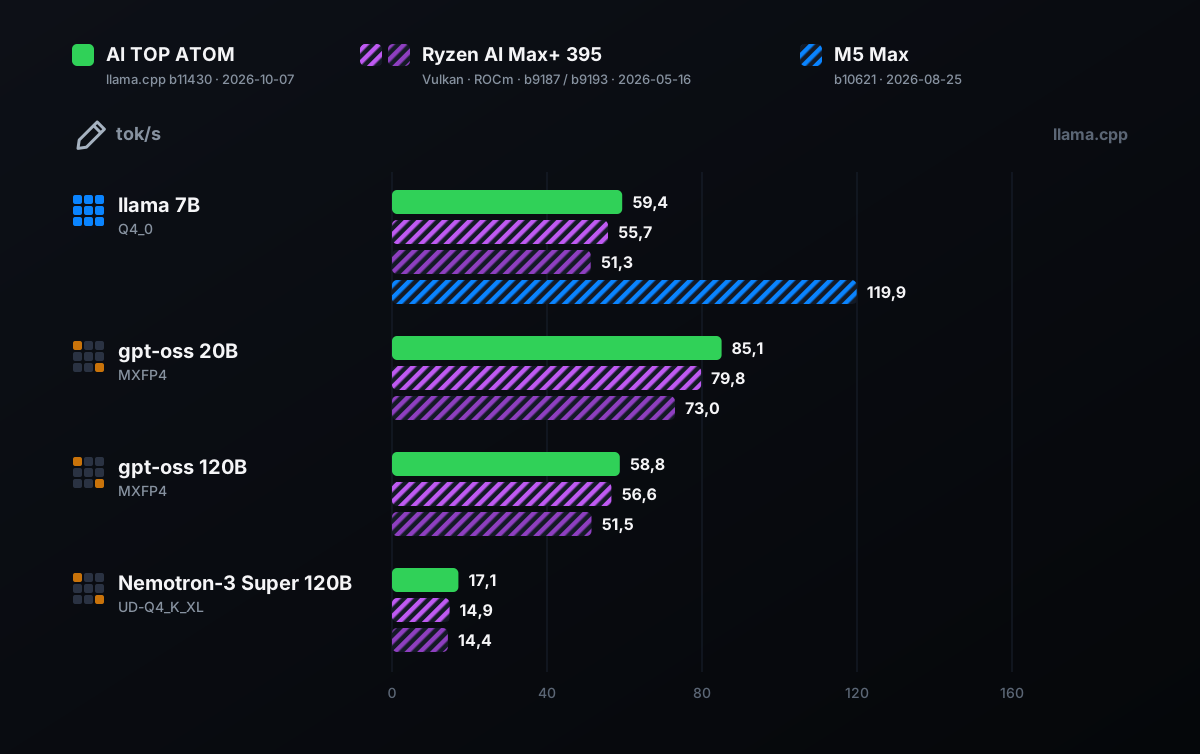
La escritura es el ritmo al que aparece la respuesta. Depende del ancho de banda de la memoria, que varía de una máquina a otra.
| Modelo | AI TOP ATOM | Ryzen, Vulkan | Ryzen, ROCm | Mac M5 Max | ATOM / mejor Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 59,4 | 55,7 | 51,3 | 119,9 | +7 % |
| gpt-oss 20B (MXFP4) | 85,1 | 79,8 | 73,0 | — | +7 % |
| gpt-oss 120B (MXFP4) | 58,8 | 56,6 | 51,5 | — | +4 % |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 17,1 | 14,9 | 14,4 | — | +15 % |
Frente a la mejor pila de software del Ryzen AI Max+ 395, el ATOM escribe entre un 4 y un 7 % más rápido en tres modelos, y un 15 % más rápido en Nemotron-3 Super 120B. Es un nivel similar: ambas memorias tienen un ancho de banda parecido y los builds difieren.
En gpt-oss 120B, un modelo de 117 mil millones de parámetros, el ATOM escribe 58,8 tokens por segundo en 128 tokens (58,0 en 32 tokens en nuestra primera guía), lo que resulta muy fluido para una conversación; el Ryzen escribe 56,6 como máximo.
El Mac M5 Max escribe más rápido, aproximadamente el doble en un modelo denso pequeño (119,9 frente a 59,4 tokens por segundo), gracias a su memoria de 614 GB/s, es decir, 2,25 veces la del ATOM.
En un modelo denso, el software puede acelerar la escritura. Con un modelo «borrador» pequeño que propone tokens que el modelo grande valida de una vez (la decodificación especulativa), Llama 3.3 70B pasa en el ATOM de 4,7 a 12 tokens por segundo con texto en francés (8 palabras de anticipación), y hasta 18,7 con código (16 palabras de anticipación): entre 2,6 y 4 veces más rápido (llama-server b11430, borrador Llama 3.2 1B, 6 y 7 de octubre de 2026). Esta técnica también existe en las demás máquinas; no la hemos medido en ellas.
#¿Qué pasa con un documento largo?
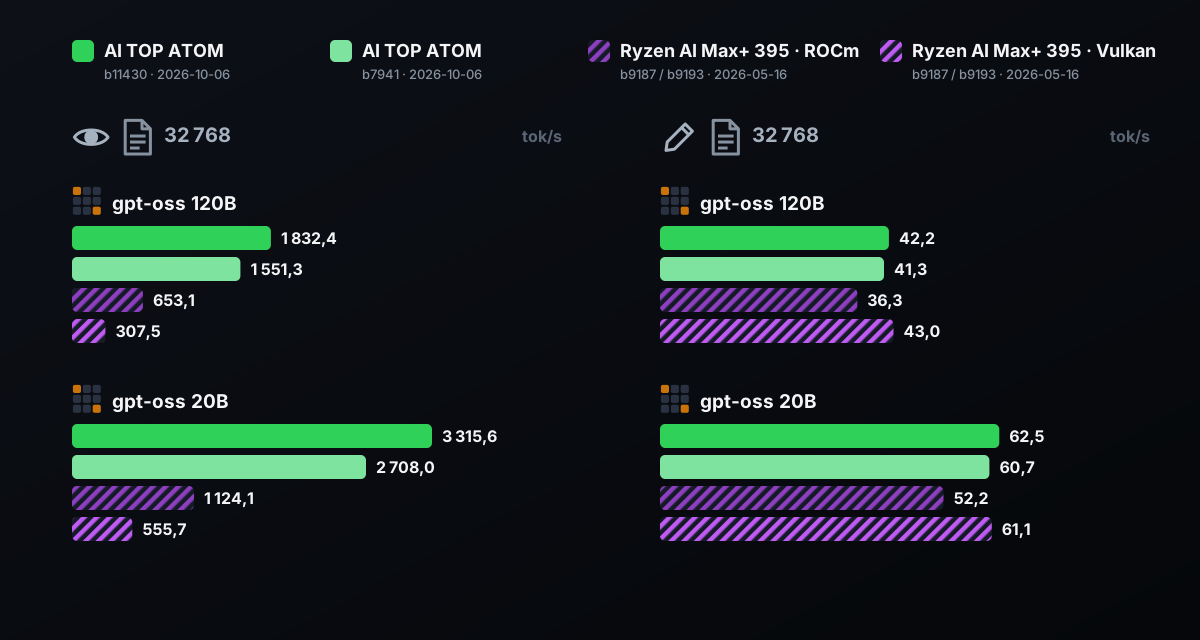
Cuanto más largo es el texto ya presente, más lenta es la continuación. La prueba de contexto largo mide la lectura y la escritura cuando ya hay 32 768 tokens en memoria, es decir, unas cincuenta páginas. La tabla compara el ATOM con el Ryzen AI Max+ 395 en los dos modelos gpt-oss, con dos builds para el ATOM. Que sepamos, no existe ninguna medición publicada en el mismo formato para el Mac.
| Modelo | Máquina y stack | Lectura a 32 768 | Escritura a 32 768 |
|---|---|---|---|
| gpt-oss 120B | AI TOP ATOM, build 11430 | 1 832,4 | 42,2 |
| gpt-oss 120B | AI TOP ATOM, build 7941 | 1 551,3 | 41,3 |
| gpt-oss 120B | Ryzen AI Max+ 395, ROCm | 653,1 | 36,3 |
| gpt-oss 120B | Ryzen AI Max+ 395, Vulkan | 307,5 | 43,0 |
| gpt-oss 20B | AI TOP ATOM, build 11430 | 3 315,6 | 62,5 |
| gpt-oss 20B | AI TOP ATOM, build 7941 | 2 708,0 | 60,7 |
| gpt-oss 20B | Ryzen AI Max+ 395, ROCm | 1 124,1 | 52,2 |
| gpt-oss 20B | Ryzen AI Max+ 395, Vulkan | 555,7 | 61,1 |
Con gpt-oss 120B, el ATOM lee 1 832 tokens por segundo con 32 768 tokens de contexto: 2,8 veces más rápido que el Ryzen AI Max+ 395 en ROCm (653) y 6 veces más rápido que en Vulkan (308). Con el build 7941, más antiguo que el del Ryzen, la ventaja sigue siendo de 2,4 veces y de 5 veces. Con gpt-oss 20B y el build 11430, la ventaja es de 2,9 y 6,0 veces.
En escritura a 32 768 tokens, el ATOM (42,2 tok/s en gpt-oss 120B) está al nivel de la mejor pila del Ryzen (43,0 en Vulkan) y por delante de la otra (36,3 en ROCm). El resultado es, por tanto, sencillo: con un documento largo, la máquina de AMD escribe igual de rápido con su mejor pila (43,0 en Vulkan), pero tarda de 2,8 a 6 veces más en leerlo.
En el uso real, con llama-server (el servidor de llama.cpp), nuestro ATOM lee un documento de 30 000 tokens en 21,8 segundos con gpt-oss 120B y luego escribe su respuesta a 42,8 tokens por segundo (medición de nuestra primera guía de la serie).
#¿Y con varios usuarios?
Cuando varias personas, o varios agentes (programas de IA que trabajan por su cuenta), consultan la máquina al mismo tiempo, un servidor como vLLM agrupa sus solicitudes y lee los pesos del modelo una sola vez para el conjunto de las solicitudes. Así, el ancho de banda deja de ser el único freno: la potencia de cálculo del GB10 toma el relevo.
En nuestra primera guía, gpt-oss 120B pasa de 35,6 tok/s para una persona a 160,3 tok/s en total para 16 personas, y cada una sigue recibiendo 10,2 tok/s. gpt-oss 20B pasa de 49,1 a 322,4 tok/s en total, con 20,7 tok/s por persona (vLLM 26.09, 6 de octubre de 2026).
La estabilidad a lo largo del tiempo importa tanto como el pico. Durante 1 h con 16 usuarios (solicitudes de 4 096 tokens, respuestas de 512), gpt-oss 120B se mantuvo en 124,8 tokens por segundo en total de principio a fin: entre 122,6 y 128,1 según los 14 tramos de medición, es decir, un 0,0 % de deriva, con la GPU a 77 °C como máximo y sin ningún throttling.
Durante 2 h con 8 usuarios en Llama 3.3 70B en NVFP4 (un formato comprimido de NVIDIA), el rendimiento total pasó de 38,7 a 38,5 tokens por segundo (−0,6 %).
StorageReview midió una carga del mismo tipo con vLLM en la máquina AMD Ryzen AI Halo, de la familia Ryzen AI Max, frente a un DGX Spark. La máquina de AMD quedó de 2 a 4 veces por detrás en la mayoría de los escenarios de alta concurrencia, y hasta 8,8 veces por detrás en una prueba con mucha lectura con gpt-oss 120B. El DGX Spark comparte el chip del ATOM; estas cifras del Ryzen proceden de la prueba de StorageReview.
#¿Qué cambia CUDA, sobre todo para el entrenamiento?
CUDA es la plataforma de software de NVIDIA para calcular en sus GPU. En el ATOM, con DGX OS 7.5.0 (CUDA 13.0, controlador 580.159.03), llama.cpp compilado para el chip, vLLM en el contenedor proporcionado por NVIDIA y Unsloth funcionaron en nuestras pruebas. Hasta donde sabemos, muchas herramientas de IA se escriben primero para CUDA: es una ventaja para servir modelos y para entrenarlos.

Para el entrenamiento, NVIDIA anuncia ajuste fino de modelos de hasta 70 mil millones de parámetros en la plataforma. Medimos dos casos con Unsloth 2026.10.1 y el método QLoRA (un ajuste fino con pesos comprimidos a 4 bits), secuencias de 1 024 tokens y 40 pasos, de los cuales los 10 primeros sirven de calentamiento.
Llama 3.3 70B requiere 41,3 GB de memoria de GPU en el pico y 9,4 segundos por paso. gpt-oss 120B requiere 64,4 GB y 6,4 segundos por paso. Así pues, dos modelos de este tamaño se entrenan dentro de la memoria del ATOM, con margen.
Un caso concreto: un ajuste fino ligero de tipo LoRA, de 85 minutos, sobre Qwen3-8B (una época, 2000 ejemplos) hizo pasar la proporción de facturas extraídas sin ningún error del 26,0 % al 95,0 %, en 200 documentos nunca vistos y con una evaluación estricta. Es mejor que gpt-oss 120B sin entrenamiento (62,5 %). Las facturas son ficticias y las hemos generado nosotros. Nuestra guía de la serie dedicada al fine-tuning explica el método en detalle.
Dos puertos QSFP (la tarjeta de red ConnectX-7, 200 Gb/s según GIGABYTE) y un puerto 10 GbE completan la máquina. Según GIGABYTE, se pueden conectar en clúster hasta cuatro máquinas GB10; no hemos probado este montaje.
#¿Cuánto cuestan estas tres máquinas?
Precios con IVA incluido consultados el 8 de octubre de 2026 en Francia, en las páginas de los comercios. Los precios de los GB10 cambian cada semana: compruébalos antes de comprar.
| Máquina | Configuración | Precio con IVA | Marchand |
|---|---|---|---|
| GMKtec EVO-X2 (Ryzen AI Max+ 395) | 128 GB, SSD de 2 TB | 3 449,99 € | gmktec.fr |
| Minisforum MS-S1 MAX (Ryzen AI Max+ 395) | 128 GB, SSD de 2 TB | 4 159,00 € | minisforumpc.fr |
| AI TOP ATOM ATAGB10-9001 | 128 GB, SSD 4 TB PCIe 4.0 | 6 346,27 € (agotada el 8 de octubre) | tienda oficial de AORUS (en stock en Amazon.fr) |
| MSI EdgeXpert (GB10) | 128 GB, SSD de 4 TB | 6 599,95 € (agotado el 8 de octubre) | Materiel.net |
| AI TOP ATOM ATAGB10-9000 | 128 GB, SSD 4 TB PCIe 5.0 | 7 999,95 € (agotado el 8 de octubre) | LDLC, Materiel.net |
| Mac Studio M5 Max (18 núcleos de CPU, 40 núcleos de GPU) | 128 GB, SSD 512 GB | 5 859 € | apple.com/fr |
| Mac Studio M5 Max (18 núcleos de CPU, 40 núcleos de GPU) | 128 GB, SSD de 4 TB | 7 839 € (cálculo) | apple.com/fr, opciones de almacenamiento |
El Ryzen AI Max+ 395 es la máquina más barata. Con el mismo almacenamiento de 4 TB, el ATOM 9000 (SSD PCIe 5.0, la versión que medimos) y un Mac Studio M5 Max están en la misma franja de precio. El ATOM 9001, con un SSD PCIe 4.0, es la máquina GB10 de 128 GB más barata de la tabla; que sepamos, mantiene el mismo chip y la misma memoria.
El SSD influye sobre todo en el tiempo de carga de un modelo, no en su velocidad de cálculo; las mediciones del SSD corresponden a la versión 9000. También indicamos el precio de un Mac Studio M5 Max, porque usa el mismo chip que las máquinas medidas en las publicaciones; su velocidad no se ha medido en esta guía.
Los dos ATOM se distinguen por su chasis de un litro (1,2 kg) y por las decisiones de GIGABYTE: refrigeración, acabados, referencias.
#Lo que esta comparativa no dice
- Origen de las mediciones
- Las cifras del Ryzen AI Max+ 395 (un Framework Desktop de 128 GB) y del Mac M5 Max proceden de publicaciones, con su build y su fecha; los mini-PC de la tabla de precios no se han medido. Interpreta las diferencias inferiores al 10 % como un empate: los builds cambian, y dos unidades de un mismo modelo difieren en un pequeño porcentaje.
- El motor MLX de Apple no se ha medido
- En Mac, MLX puede ofrecer velocidades distintas a las de llama.cpp o Ollama. Nuestra guía MLX frente a llama.cpp explica esta diferencia en detalle.
- Un solo modelo en común con el Mac
- El formato llama-bench publicado para el M5 Max solo cubre llama 7B. Para los modelos grandes, solo tenemos la medición Ollama de un lector.
- La calidad de las respuestas
- Esta guía compara velocidades, no la calidad de los modelos.
- Varios usuarios y entrenamiento en las otras máquinas
- No los hemos medido ni en el Ryzen ni en el Mac. Para el Ryzen, citamos a StorageReview.
Actualizaciones y correcciones: esta página se revisará si un nuevo build de llama.cpp o una nueva publicación cambia estos resultados; cada corrección llevará fecha.
#Para quién es ATOM la opción adecuada
Lo que sigue procede de nuestras mediciones en el ATOM y de las cifras publicadas citadas más arriba.
- El ATOM es la opción adecuada si lees documentos largos o código
- Lee gpt-oss 120B 2,8 veces más rápido que el Ryzen AI Max+ 395 con 32 768 tokens en memoria, y un documento de 30 000 tokens en 21,8 segundos.
- … si varias personas o agentes comparten la máquina
- 160,3 tokens por segundo en total para 16 usuarios con gpt-oss 120B; con solicitudes más largas, el rendimiento se mantuvo en 124,8 tokens por segundo durante 1 hora, sin caídas.
- … si entrenas o adaptas modelos
- Un QLoRA con 70 000 millones de parámetros cabe en 41,3 GB. Un LoRA con facturas tardó 85 minutos.
- … si quieres grandes modelos MoE en una caja de un litro
- gpt-oss 120B escribe 58,8 tokens por segundo en una máquina de 1,2 kg.
- Un Mac M5 Max es más adecuado si escribes solo con modelos densos pequeños
- Escribe aproximadamente el doble de rápido en llama 7B (119,9 frente a 59,4 tokens por segundo).
- Un mini-PC Ryzen AI Max+ 395 es más adecuado si lo que manda es el presupuesto
- La escritura es similar en los modelos MoE, desde 3 449,99 €, pero la lectura es entre 2,1 y 2,8 veces más lenta.
En resumen: si tu trabajo consiste en leer textos largos, el ATOM es la opción adecuada según nuestras comparaciones. Para dar servicio a varias personas o entrenar, sus propias mediciones son sólidas: 160,3 tokens por segundo en total para 16 usuarios y un QLoRA de 70 mil millones de parámetros en 41,3 GB. Si escribes solo con modelos densos pequeños, fíjate en el Mac. Si lo que manda es el presupuesto, fíjate en el Ryzen.
#FAQ
¿Qué máquina es la más rápida entre el GB10, el Ryzen AI Max+ 395 y el Mac M5 Max?+
¿Es el AI TOP ATOM más rápido que un Mac M5 Max?+
¿Por qué las cifras de una misma máquina cambian de un sitio web a otro?+
¿Cómo comparo mi propia máquina con estas cifras?+
¿Es el Ryzen AI Max+ 395 una buena opción frente al GB10?+
¿Un comentario, un error, una precisión? Avísanos, eso mejora la guía para todos.