Fine-tuning en local en GB10: mediciones y metodología
En una GIGABYTE AI TOP ATOM (chip NVIDIA GB10, 128 GB), un modelo pequeño entrenado para una tarea concreta puede superar a un modelo muy grande en esa tarea. Con 85 minutos de LoRA, Qwen3-8B extrae sin ningún error los datos del 95 % de 200 facturas ficticias nunca vistas, frente al 62,5 % de gpt-oss 120B y el 26 % sin entrenamiento. El QLoRA con Unsloth también cabe: 41 GB para un 70B, 64 GB para gpt-oss 120B. El entrenamiento costó 1,5 céntimos de electricidad de la GPU.
El fine-tuning entrena un poco más un modelo existente para que resuelva bien una tarea concreta. Con 128 GB de memoria unificada, una máquina GB10 lo hace en tu casa, sin alquilar un servidor ni confiar tus datos a un servicio en línea. Esta guía sigue un caso completo, medido en una AI TOP ATOM cedida gratuitamente por GIGABYTE: extraer en JSON los datos de facturas. También ofrece las mediciones de QLoRA (el mismo método sobre un modelo comprimido a 4 bits) con Unsloth hasta gpt-oss 120B, y los comandos de nuestras pruebas.
#El caso real: leer facturas y generar JSON
La tarea es habitual en una pequeña empresa: a partir del texto de una factura, un presupuesto o una nota de crédito, el modelo debe devolver un JSON, es decir, una ficha estructurada que un programa puede leer. Esta ficha tiene 31 campos evaluados: tipo de documento, número, fechas, emisor, cliente, líneas de productos, descuento, totales, IVA, anticipo, IBAN. Elegimos esta tarea porque la respuesta se comprueba campo por campo, sin que otro modelo tenga que juzgarla.
Los documentos son ficticios. Un pequeño programa generó 12 diseños, es decir, 12 formatos de factura, con nombres de empresas inventados. Su aleatoriedad se controla con una «semilla» fija: genera los mismos documentos en cada ejecución. El entrenamiento usa 2 000 documentos con 10 diseños.
La evaluación usa 200 documentos nunca vistos: 100 con los mismos 10 diseños de página y 100 con 2 diseños ausentes del entrenamiento. Estos últimos 100 indican si el modelo ha comprendido la tarea o si solo ha memorizado formas.
El modelo recibe el texto del documento, no una imagen ni un PDF. Aquí tienes un extracto de la respuesta del modelo entrenado para el primer documento de prueba, una nota de crédito ficticia de cuatro líneas.
#El método: LoRA, una época, 85 minutos
Aprovecha nuestra experiencia y un recorrido guiado para crear tu asistente local y usar tu IA en el día a día.
- Espacio en línea de por vida
- PDF + archivos
- Reembolsado 30 d
La máquina es una GIGABYTE AI TOP ATOM, referencia ATAGB10-9000: chip NVIDIA GB10, 128 GB de memoria unificada, SSD de 4 TB en PCIe 5.0, con DGX OS 7.5.0 (controlador 580.159.03, CUDA 13.0). El software: el contenedor PyTorch de NVIDIA (versión 26.03, con PyTorch 2.11), PEFT 0.21.2 para LoRA, Unsloth 2026.10.1 para QLoRA y, para el servicio, el contenedor vLLM 26.09 de NVIDIA (vLLM 0.29.0). Nuestra primera guía de la serie detalla la máquina y la velocidad de 13 modelos.
LoRA (Low-Rank Adaptation) deja intacto el modelo original y entrena pequeñas matrices añadidas a sus capas. El resultado es un adaptador, un archivo pequeño que se carga junto con el modelo. Aquí se entrenan 43,6 millones de parámetros, frente a 8 mil millones de Qwen3-8B.
Hay tres palabras que se repiten en esta guía. Un paso de entrenamiento procesa un lote de 4 documentos. Una época es una pasada completa por los 2000 documentos. La pérdida mide la diferencia entre la respuesta escrita por el modelo y la respuesta esperada: cuanto más baja, mejor.
- Modelo
- Qwen3-8B en bf16, un formato numérico de 16 bits, sin compresión.
- LoRA
- Rango 16, alfa 32 (un coeficiente de escala), dropout 0,05 (una pequeña parte de los valores se ignora al azar en cada paso para limitar el sobreajuste), en las 7 proyecciones de cada capa, es decir, sus 7 matrices de pesos: q, k, v, o, gate, up, down. El rango determina el tamaño de las matrices añadidas.
- Duración
- 1 época: 500 pasos de 4 documentos.
- Tasa de aprendizaje
- 1e-4, es decir, 0,0001, con un aumento progresivo durante 30 pasos y luego un decaimiento coseno.
- Lots
- Ordenamos los 2 000 documentos por longitud, formamos los lotes y luego mezclamos su orden con una semilla fija. Un lote contiene documentos de longitud similar: hay menos relleno innecesario, por lo que el entrenamiento es más rápido.
- Perte
- Calculada solo sobre la respuesta JSON. La instrucción y el documento están enmascarados: el modelo aprende a escribir la respuesta, no a copiar el documento.
- Longitud
- Hasta 2 304 tokens. El documento más largo tiene 2 204 y la media es de 1 143: ninguno se corta.
- Memoria
- El gradient checkpointing está activo: el modelo recalcula algunos resultados en lugar de conservarlos todos en memoria.
Estos ajustes se fijaron mediante una adenda a nuestro protocolo, fechada el 7 de octubre de 2026, antes de cualquier evaluación con los 200 documentos de prueba. El protocolo se congeló antes de la primera medición; el método, la lista fechada de adendas y los datos de nuestras tablas están publicados en nuestra página de metodología. Las memorias de esta guía están en GB, como las muestra Linux: 1 GB = 1024 MB.
Todo ocurre en el contenedor PyTorch de NVIDIA (versión 26.03). En él, un entorno de Python recibe las bibliotecas transformers y PEFT. Las rutas siguientes están simplificadas; las opciones son las de nuestras pruebas.
#Los resultados: 95 % de documentos perfectos
La puntuación compara, campo por campo, el valor escrito por el modelo con el valor esperado, tras la normalización. Un documento es «perfecto» cuando todos sus campos son exactos. Los tres modelos reciben la misma instrucción, con temperatura 0 (el ajuste que hace que las respuestas sean más estables), mediante vLLM 26.09, con 16 documentos a la vez. En Qwen3-8B, la reflexión está desactivada. En gpt-oss 120B, el esfuerzo de razonamiento está configurado en «bajo».
| Modelo | Campos exactos | Documentos perfectos | Perfectos, diseños de página conocidos | Perfectos, diseños nuevos | Duración para 200 documentos |
|---|---|---|---|---|---|
| Qwen3-8B sin entrenamiento | 84,8 % | 26,0 % | 27 % | 25 % | 686 s |
| gpt-oss 120B sin entrenamiento | 97,5 % | 62,5 % | 58 % | 67 % | 991 s |
| Qwen3-8B + LoRA (85 min) | 99,2 % | 95,0 % | 96 % | 94 % | 524 s |
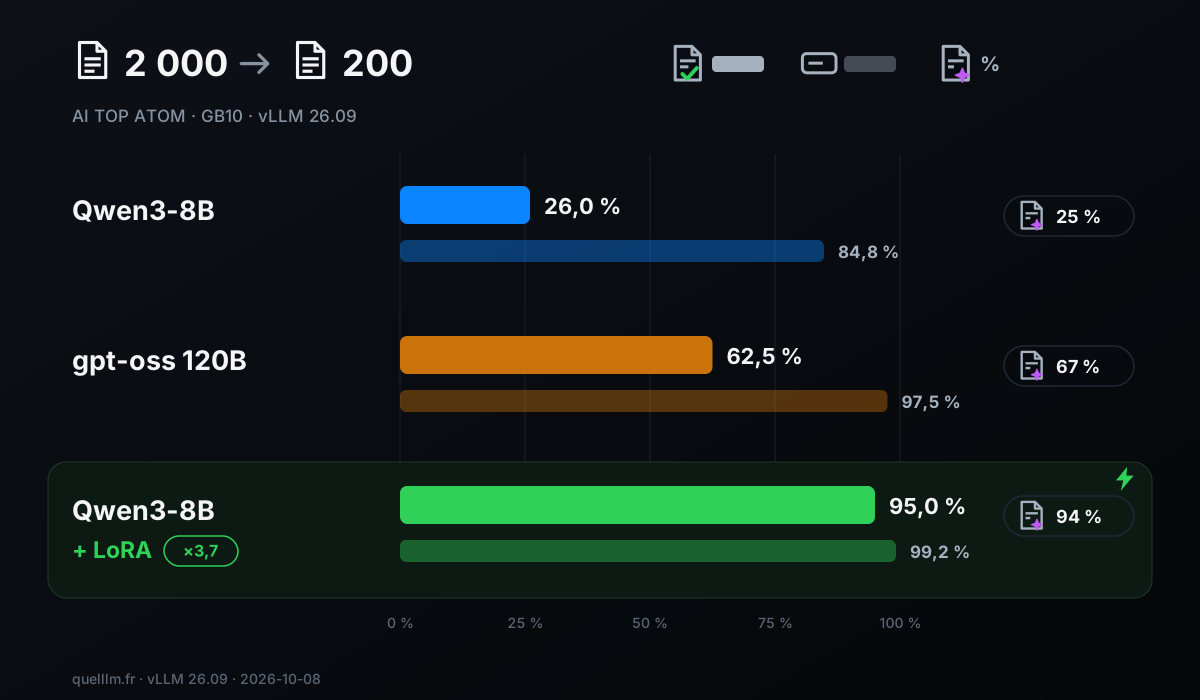
El modelo entrenado obtiene un 95,0 % de documentos perfectos, frente al 26,0 % del mismo modelo sin entrenamiento: 69 puntos más, es decir, 3,7 veces más documentos sin errores. Supera a gpt-oss 120B (62,5 %), un modelo de 117 mil millones de parámetros. También es el más rápido: 524 segundos para los 200 documentos, frente a 991 segundos de gpt-oss 120B y 686 segundos de Qwen3-8B sin entrenamiento. Sus respuestas también son más cortas: 98 847 tokens escritos, frente a 160 702 de gpt-oss 120B.
En los 100 documentos con diseños nunca vistos, el modelo entrenado mantiene un 94 % de documentos perfectos y un 98,5 % de campos exactos, frente al 96 % y el 99,9 % en los diseños conocidos. La diferencia es de 2 puntos en los documentos perfectos (96 % frente a 94 %): el adaptador no se limita a las formas vistas durante el entrenamiento.
El detalle por campo muestra lo que corrigió el entrenamiento. Los 31 campos son exactos en al menos el 97,5 % de los documentos, y 18 de ellos lo son en el 100 % de los documentos. Sin entrenamiento, 10 campos son exactos entre el 49,5 % y el 61,5 % de las veces: los importes (descuento, totales, IVA, anticipo, neto a pagar) y las líneas (cantidad, precio unitario, tipo de IVA, importe). Después del entrenamiento, estos 10 campos son exactos entre el 98 % y el 100 %.
Los tres modelos devuelven un JSON válido en el 100 % de los casos y encuentran el número correcto de líneas en el 100 % de los documentos. Por tanto, la diferencia está en el valor de los campos, no en la forma de la respuesta.
#Lo que cuesta: tiempo, memoria, electricidad
| Medición | Valor |
|---|---|
| Duración del entrenamiento | 5 090 s, es decir, 85 min (10,2 s por paso) |
| Pico de memoria de la GPU registrado por PyTorch | 33,3 GB |
| Potencia de la GPU, media y pico | 53,0 W y 62,7 W |
| Temperatura de la GPU, media y máxima | 65 °C y 77 °C |
| Limitación de rendimiento notificada por la GPU | ninguno en las 5 206 lecturas |
| Energía de la GPU para el entrenamiento (87 minutos de registro, carga incluida) | 76,7 Wh |
| Costo con la tarifa EDF Tarif Bleu Base (20,01 céntimos por kWh, impuestos incluidos) | 1,5 céntimos |
| Energía de la GPU para leer los 200 documentos de prueba con el modelo entrenado | unos 6 Wh |
Estas cifras corresponden solo a la GPU, tal como la informa el propio chip. Según NVIDIA, la potencia que muestra nvidia-smi es la de la GPU sola. No se cuentan el procesador, la memoria, el SSD ni la fuente de alimentación. La tarifa es la de la opción Base de EDF para 6 kVA, en la tabla aplicable a partir del 1 de agosto de 2026; no se cuenta la cuota de suscripción.
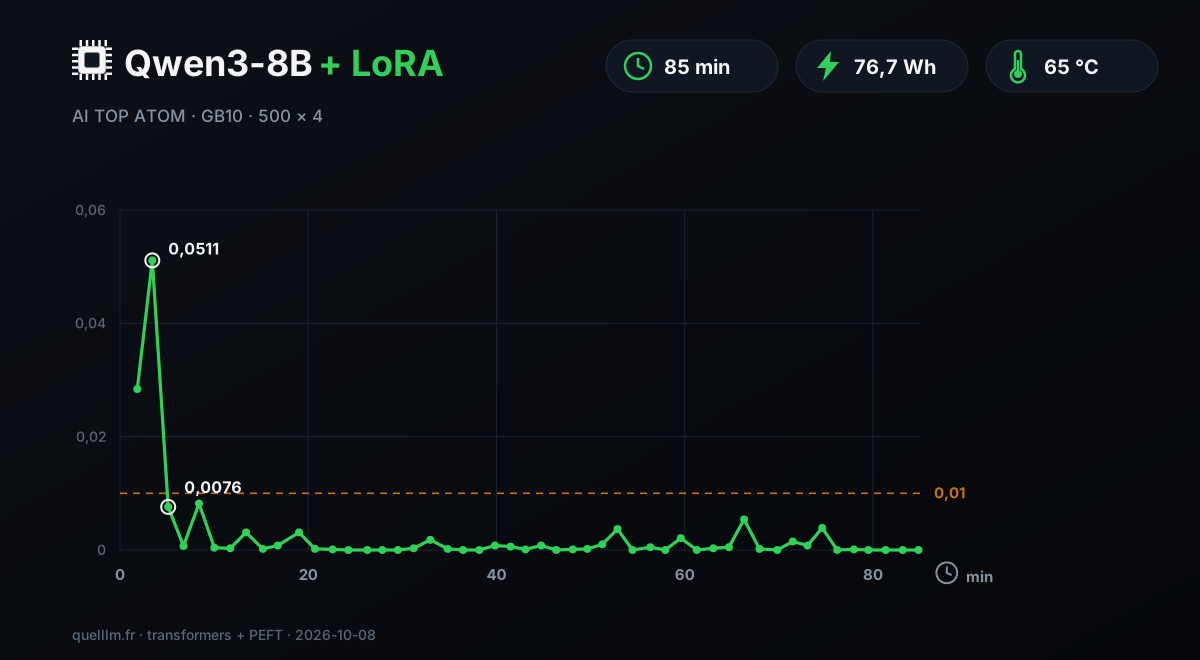
Cada punto de la curva procede de un solo lote de 4 documentos, por lo que los valores varían de un registro a otro. La pérdida baja de 0,01 desde el paso 30, tras 5 minutos de entrenamiento, y ningún registro posterior supera 0,0082. Una sola época bastó para alcanzar un 95 % de documentos perfectos en este caso.
#QLoRA con Unsloth: un 70B y gpt-oss 120B en la misma máquina
QLoRA comprime los pesos del modelo a 4 bits, lo que reduce mucho el espacio que ocupa en memoria, y luego entrena un adaptador LoRA encima. Es la vía para especializar un modelo grande sin cambiar de máquina. Usamos Unsloth, una herramienta libre que, según su editor, aligera y acelera el fine-tuning.
NVIDIA publica una guía oficial para Unsloth en DGX Spark, dentro de un contenedor PyTorch de NVIDIA (versión 25.11), y también ofrece un entorno oficial de fine-tuning con PyTorch para modelos de 1 a 70 mil millones de parámetros. Unsloth anuncia unos 68 GB de memoria para un QLoRA de 4 bits de gpt-oss 120B; nuestra medición da un pico de 64,4 GB, del mismo orden.
Medimos la velocidad y la memoria en dos modelos: Llama 3.3 70B y gpt-oss 120B, ambos en el formato de 4 bits publicado por Unsloth. Cada prueba consta de 40 pasos, y los 10 primeros, que sirven de puesta en marcha, no se incluyen en la media.
Las secuencias tienen 1 024 tokens, con un lote de 1 y un LoRA de rango 16. Estos pasos, realizados sobre el texto de referencia de nuestro protocolo, miden el rendimiento y la memoria; no producen un modelo útil.
| Modelo | Chargement | Memoria del modelo | Pico de memoria de la GPU | Segundos por paso | Tokens por segundo | Parámetros entrenados |
|---|---|---|---|---|---|---|
| Llama 3.3 70B (QLoRA de 4 bits) | 247 s | 37,6 GB | 41,3 GB | 9,39 | 109 | 207 millones (7 proyecciones) |
| gpt-oss 120B (QLoRA de 4 bits) | 397 s | 58,5 GB | 64,4 GB | 6,35 | 161 | 11,9 millones (4 proyecciones de atención) |
| Qwen3-8B (LoRA bf16) | — | — | 63,4 GB | 5,42 | 756 | 43,6 millones (7 proyecciones) |
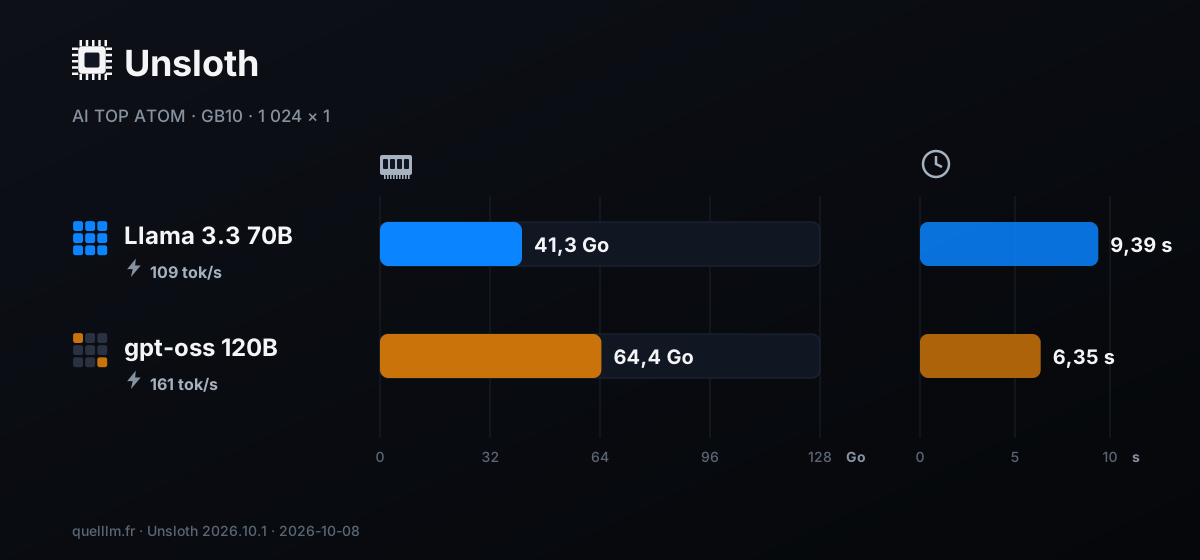
El 70B se entrena con un pico de 41,3 GB, cerca de un tercio de los 121,7 GB que ve el sistema; gpt-oss 120B requiere 64,4 GB. En ambos casos queda espacio para otros servicios. Un dato destacable: gpt-oss 120B avanza más rápido por paso que el 70B (6,35 s frente a 9,39 s), a pesar de ser más grande.
Es un modelo MoE, una «mezcla de expertos»: en cada token solo usa 5,1 de sus 117 mil millones de parámetros. Solo entrenamos las 4 matrices de la atención (q, k, v, o), es decir, 11,9 millones de parámetros. El 70B recibe un LoRA en sus 7 proyecciones, es decir, 207 millones de parámetros entrenados.
Para planificar, aquí tienes un cálculo a partir de nuestras mediciones. 1000 pasos de 1024 tokens, es decir, alrededor de un millón de tokens, tardarían 2 h 36 min con el 70B y 1 h 46 min con gpt-oss 120B. Comprueba estas duraciones con tu conjunto de datos. El QLoRA del 70B ocupó la GPU durante 10,8 minutos, incluida la carga del modelo, con 8,9 Wh en la GPU.
Unsloth 2026.10.1 está instalado en el mismo entorno de Python que arriba, en el mismo contenedor de PyTorch. Para la instalación paso a paso, sigue la guía oficial de NVIDIA y la documentación de Unsloth, enlazadas al final de la página.
#Servir el modelo entrenado con vLLM
vLLM es un servidor libre, diseñado para responder a varias personas a la vez; lo usamos en el contenedor que proporciona NVIDIA. Carga el modelo original y luego le añade el adaptador. La API expone entonces dos nombres: Qwen3-8B, sin adaptador, y factures, con el adaptador. Evaluamos ambos en el mismo servidor, lo que hace que la comparación sea justa.
Con 16 documentos enviados a la vez, las 200 facturas se procesan en 524 segundos. A este ritmo, 1 000 facturas tardan unos 44 minutos: es un cálculo a partir de nuestra medición. El puerto está vinculado a la dirección local 127.0.0.1. Para abrir el servicio a tu red, añade una clave de API; la guía sobre vLLM en producción detalla este paso.
#Reproduce este caso por tu cuenta en cinco pasos
- 01Prepara los ejemplosReúne pares: el texto de un documento y la respuesta JSON esperada. Escribe una sola instrucción, la misma para el entrenamiento y para la evaluación. Usamos 2 000 ejemplos; no hemos medido un umbral mínimo.
- 02Conserva un conjunto de pruebaAparta documentos sin mostrárselos nunca al modelo. Añade algunos diseños de página ausentes del entrenamiento, para saber si el modelo generaliza.
- 03Entrena una épocaOrdena los ejemplos por longitud, forma los lotes, calcula la pérdida solo sobre la respuesta y vigila la curva de pérdida.
- 04Puntúa antes y despuésPuntúa el modelo original y el modelo entrenado con la misma instrucción, campo por campo. Puntúa también un modelo grande sin entrenamiento: es la comparación más útil.
- 05Sirve el modelo con vLLMCarga el adaptador con la opción enable-lora y conecta tu software a la API.
#Fine-tuning, RAG o una instrucción mejor: ¿qué elegir?
Empieza por la instrucción: es gratis e inmediato. Si el modelo debe encontrar datos en tus documentos, un RAG es más adecuado: es un asistente que primero busca en tus archivos antes de responder.
El fine-tuning es la herramienta adecuada cuando la tarea se repite, el formato de salida debe mantenerse estable y tienes ejemplos. La lectura de facturas cumple estas tres condiciones. Ambos enfoques se pueden combinar en la misma máquina; otra guía de la serie muestra un asistente RAG completo.
#Los límites de nuestras mediciones
- Documentos ficticios
- Nuestras facturas las genera un script, con 12 diseños. Los documentos reales, escaneados o fotografiados, requieren primero una lectura del texto (OCR) y pueden dar otros resultados.
- Un solo entrenamiento
- Entrenamos un solo adaptador y evaluamos cada modelo una vez, con temperatura 0. No medimos la variación entre un entrenamiento y otro ni comparamos con un entrenamiento más largo.
- gpt-oss 120B
- Se evalúa con un esfuerzo de razonamiento bajo. Otro ajuste puede cambiar su puntuación.
- QLoRA
- Las mediciones de QLoRA se refieren a la velocidad y la memoria, en 40 pasos. No evaluamos la calidad de modelos 70B o 120B entrenados.
- Energía
- Se refiere solo a la GPU.
- Fuera de alcance
- No medimos el entrenamiento de todos los parámetros de un modelo ni el uso de varias máquinas conectadas.
Actualizaciones y correcciones: esta página se revisará si una nueva versión de Unsloth, de vLLM o de DGX OS cambia estos resultados; cada corrección estará fechada.
#Para quién es ATOM la opción adecuada
- Una pyme o un despacho profesional que quiere especializar un modelo pequeño en sus documentos
- 85 minutos y 1,5 céntimos de electricidad de la GPU para pasar del 26 % al 95 % de facturas perfectas en nuestro conjunto de facturas ficticias, sin enviar ni un solo documento a terceros.
- Un desarrollador o un equipo de datos que crea prototipos
- Qwen3-8B con LoRA, un 70B o gpt-oss 120B con QLoRA: los tres caben en la misma máquina, con entre 33 y 64 GB de pico de memoria de GPU.
- Un equipo que quiere entrenar, evaluar y servir en el mismo lugar
- La misma máquina entrenó el adaptador, evaluó tres modelos y sirvió las respuestas con vLLM.
- Una oficina sin sala de servidores
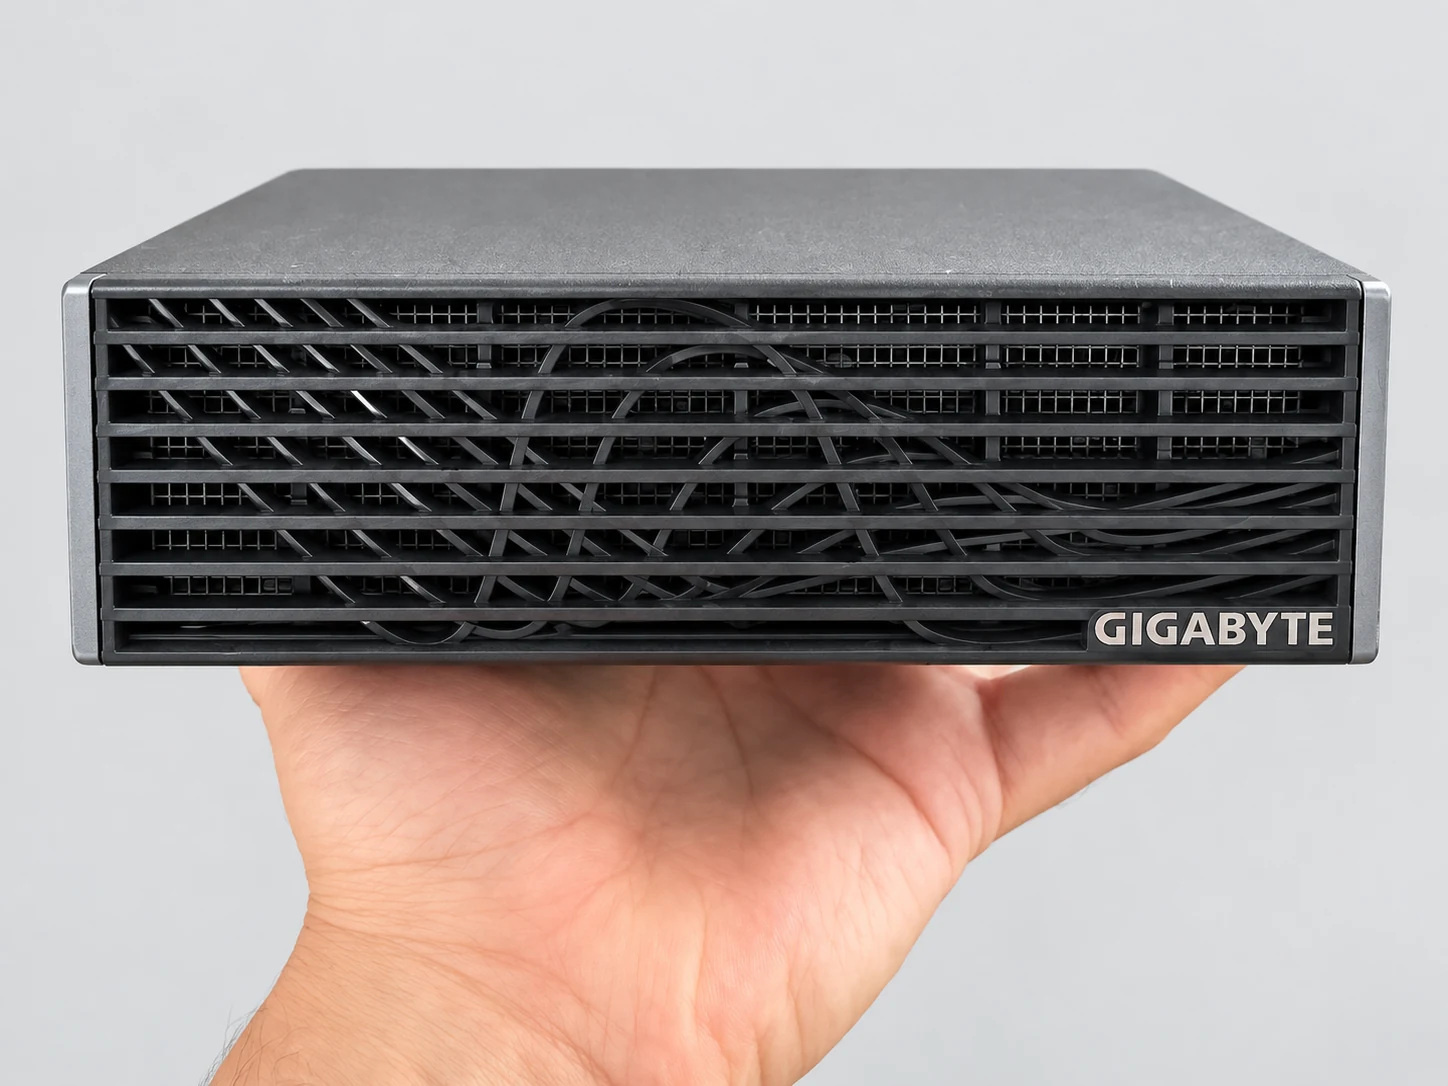
- Una carcasa de un litro (150 × 150 × 50,5 mm, 1,2 kg) alimentada por un adaptador USB-C de 240 W.
Separemos la plataforma y el fabricante. El chip NVIDIA GB10, sus 128 GB de memoria unificada a 273 GB/s, CUDA y DGX OS 7.5.0 determinan la mayor parte de las velocidades de entrenamiento. En inferencia, nuestras mediciones difieren como máximo un 4,3 % de las publicadas para el DGX Spark; los entrenamientos de esta guía se realizaron en la AI TOP ATOM.
GIGABYTE aporta el chasis y su refrigeración con dos ventiladores. Durante los 87 minutos de registro del entrenamiento, con 53 W de media en la GPU, la temperatura se mantuvo en 65 °C de media y 77 °C como máximo, sin ninguna limitación de rendimiento notificada.
Precios consultados el 8 de octubre de 2026 para la ATAGB10-9001 (128 GB, SSD de 4 TB en PCIe 4.0): 6346,27 € con impuestos incluidos en la tienda oficial de AORUS, donde estaba agotada; estaba disponible en Amazon.fr. Medimos la referencia ATAGB10-9000, cuyo SSD es PCIe 5.0. Los precios de las GB10 cambian cada semana: compruébalos antes de comprar.
#FAQ
¿Cuánto tiempo se tarda en hacer fine-tuning de un modelo de 8 mil millones de parámetros en una GB10?+
¿Se puede hacer fine-tuning de un modelo 70B o gpt-oss 120B con 128 GB?+
¿De verdad un modelo pequeño entrenado puede superar a un modelo grande?+
¿Cuánto cuesta la electricidad de un fine-tuning?+
¿Cómo se usa el adaptador una vez terminado el entrenamiento?+
¿Hace falta la versión de 128 GB de la ATOM para hacer fine-tuning?+
¿Un comentario, un error, una precisión? Avísanos, eso mejora la guía para todos.