La guía de referencia · 25 capítulos · configuraciones incluidas · actualizaciones de por vida
Tu copiloto de código,
100 % local

Este kit está redactado en español (PDF y espacio en línea), con el original en francés incluido. El pago se procesa de forma segura con Stripe.
El kit Copiloto Local: LA guía de referencia para montar tu propio copiloto de IA en tu máquina: desde el primer comando hasta el agente que programa en tu editor. Tu código y tus datos nunca salen de tu disco.
Por 25 € más: los 9 kits actuales y los próximos.
Pago único · actualizaciones de por vida incluidas
- Tu objetivo
- Un copiloto local en VS Code.El recorrido para configurar tu asistente de código y sus herramientas.
- Lo que recibes
- El kit completo para crear tu propio copiloto de IA.Aprovecha nuestra experiencia práctica y un recorrido guiado para pasar a la acción, desde la instalación hasta el uso en el día a día.
- Para tu equipo
- GPU dedicada o Mac con Apple Silicon.Recorridos a partir de 8 GB de VRAM en GPU, con ajustes según tu hardware.
¿Qué es el kit Copiloto Local?
El kit Copiloto Local es una guía de referencia de 25 capítulos, con las configuraciones de Cline, Aider y Tabby y un espacio en línea de por vida que se actualiza cada mes. Está dirigido a desarrolladores, profesionales independientes y estudiantes que quieren programar con una IA local en VS Code, en una GPU con al menos 8 GB de VRAM o en un Mac Apple Silicon, en 30 minutos, para sustituir la mayor parte del uso de GitHub Copilot o Cursor.

✓ Para ti si…
quieres tu propio copiloto de IA en tu equipo: eres desarrollador profesional, freelance, estudiante o simplemente te manejas bien con un ordenador. Te preocupan la privacidad, el coste o la dependencia de la nube, y tienes una GPU con unos cuantos GB de VRAM o un Mac con Apple Silicon.
✗ No es para ti si…
quieres un asistente que programe proyectos enteros por sí solo en múltiples repositorios, o si cada milisegundo de latencia te cuesta dinero. En estos ámbitos, la nube mantiene la ventaja — y te lo decimos en la guía.
Por qué puedes confiar en él
Esta guía está escrita y mantenida por el equipo de QuéLLM — 258 modelos indexados, 382 guías, actualizado cada mañana — que además opera plataformas de IA en producción todo el año (RegulIA, IAPRO). Lo que lees aquí es nuestra experiencia sobre el terreno: condensada, probada y sin rodeos. No es una recopilación de tutoriales encontrados al azar. ¿Quién está detrás de QuéLLM? →
El problema
Desde el 24 de abril de 2026, GitHub Copilot se entrena con tu código por defecto (Free/Pro/Pro+). Cursor se vuelve cada vez más caro y cobra por uso. Y con cada prompt, tu código propietario pasa por un tercero.
Sabes que un LLM local resuelve todo esto. Pero entre «¿qué modelo para mi tarjeta?», la cuantización, los fallos de Ollama y 12 pestañas de tutoriales contradictorios… aún no tienes una configuración que funcione de verdad. El kit es EL método de referencia: el recorrido completo, probado de principio a fin, con las configuraciones incluidas, sin tener que buscar nada en otro sitio.
El copiloto local frente a GitHub Copilot frente a Cursor
El mismo trabajo en VS Code — sin suscripción y sin enviar tu código a ningún otro sitio. La comparativa honesta:
| Copiloto local | GitHub Copilot | Cursor | |
|---|---|---|---|
| Tu código permanece en tu máquina | Sí | No | No |
| Entrenado con tu código | Nunca | Sí, de forma predeterminada | Según la configuración |
| Coste | 0 €/mes | ~10 €/mes | ~20 €/mes |
| Funciona sin conexión | Sí | No | No |
| Chat + agente en tu repositorio | Sí (Cline) | Sí | Sí |
| Autocompletado | Sí (con GPU) | Sí | Sí |
| Razonamiento intensivo sobre varios repositorios | Limitado | Fuerte | Fuerte |
La guía te muestra cómo cubrir ~90 % de tu uso de Copilot/Cursor en local y te dice sinceramente en qué aspectos la nube sigue teniendo ventaja.
Lo que obtienes
- Tu espacio en línea, de por vida — los 25 capítulos disponibles para leer en la web, siempre la última edición, cada comando se puede copiar con un clic (los tokens FIM exóticos se conservan al copiar y pegar, algo que un PDF no garantiza).
- La guía completa en PDF (~173 páginas) — el mismo contenido, tuyo para siempre, sin conexión.
- Las configuraciones listas para pegar — Cline (VS Code), Aider (terminal), Tabby (autocompletado), por niveles de VRAM.
- Los Modelfiles optimizados + una biblioteca de 44 prompts — por modelo y por rol (chat / edición / autocompletado), tokens FIM correctos incluidos.
- 8 módulos avanzados — evaluar el rendimiento de tu máquina, múltiples proyectos, RAG sobre tu documentación, pre-commit local, endurecimiento, prompts — y los nuevos: tu ChatGPT privado (Open WebUI / AnythingLLM) y la IA local en el trabajo (RGPD, Ley de IA, nota para la dirección de TI).
- El capítulo «cuando falla» — OOM, GPU sin usar, lentitud: el diagnóstico + la solución para cada fallo.
- La chuleta — tu VRAM → el modelo adecuado → el comando, en una página.
- Edición en actualización continua — recibes cada actualización mensual (nuevos modelos, configuraciones reajustadas) sin tener que volver a pagar nada.
Stack: Ollama + Cline + Aider + Tabby. Modelos: Qwen2.5-Coder, Qwen3-Coder, Devstral, DeepSeek-Coder. 100 % local, 0 €/mes.
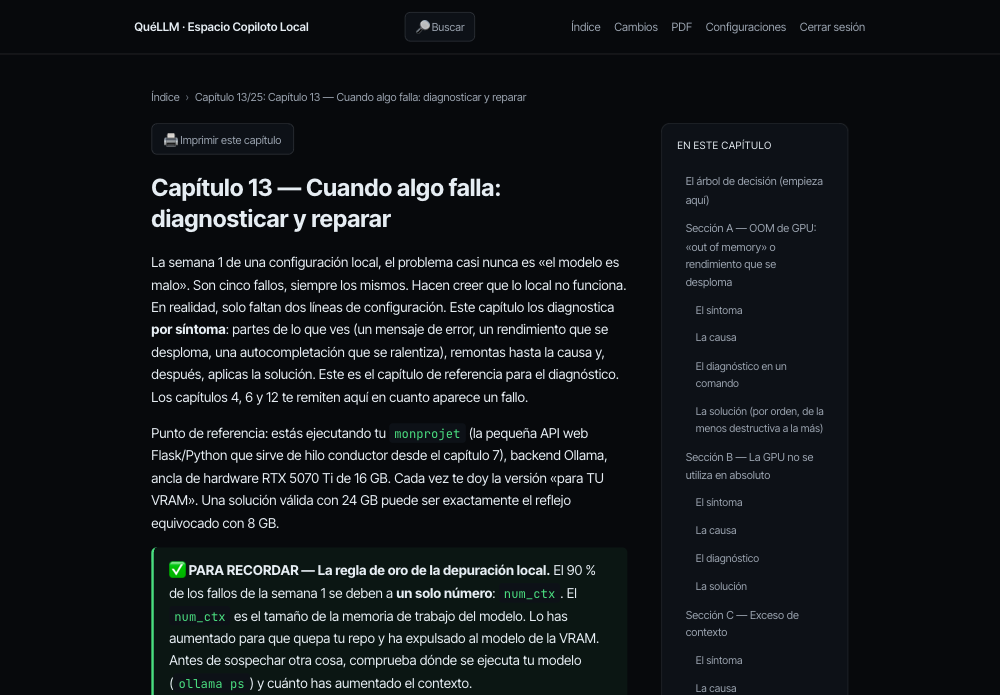
Los 25 capítulos del kit
~173 páginas, desde el quick win de 30 minutos hasta los módulos avanzados que no encontrarás en ningún otro sitio. No te saltes nada: cada capítulo remite a los siguientes.
- ¿Por qué programar en local en 2026?
- Tu primer copiloto local en 30 minutos
- Lo que te ofrece la IA local y dónde sale perdiendo
- Instalar Ollama correctamente
- El modelo adecuado según tu VRAM
- ¿Tu máquina es suficiente y cuándo conviene mejorarla?
- Cline + Ollama en VS Code
- Aider en el terminal, tu compañero de programación que entiende Git
- Autocompletado FIM: el Copilot integrado, en local
@codebase— RAG sobre tu repositorio- Modelfiles por modelo × función
- Los ajustes que lo cambian todo
- Cuando falla: diagnosticar y reparar
- El coste real del modelo
- Modelo de amenazas concreto: lo que sale de tu equipo
- Leer una edición fechada
- Registro de actualizaciones fechado + Anexo A: ir más allá
- Medir el rendimiento de TU máquina en 10 minutos (VRAM real + tasa real de tok/s, no la ficha técnica)
- Flujo de trabajo multiproyecto: varios repositorios, un solo Ollama
- RAG local sobre documentación (no tu código: tus PDF, tus especificaciones)
- Hook pre-commit 100 % local: un revisor antes de cada push
- Reforzar el entorno: del «no sale nada» comprobado a la garantía permanente
- Biblioteca de 44 prompts rigurosos, listos para copiar y pegar
- Tu ChatGPT privado: un asistente local para todo, no solo para el código (Open WebUI / AnythingLLM)
- La IA local en el trabajo: convencer a tu empresa (RGPD, Ley de IA, nota para la dirección de TI lista para enviar)
Cada edición mensual amplía este índice (registro de actualizaciones fechado, cap. 16-17): no tienes que volver a comprar nada cuando salga la próxima versión.
Instalado en 30 minutos, paso a paso
No necesitas ser experto. La guía te acompaña paso a paso, desde el primer comando hasta el copiloto que responde en tu editor:
1 · Instala Ollama
Un comando. La guía te dice qué modelo descargar según tu tarjeta (la tabla de VRAM, más abajo).
2 · Descarga el modelo adecuado
ollama run qwen2.5-coder:7b — y compruebas que tu GPU realmente está trabajando.
3 · Conecta tu editor
Cline (chat + agente en VS Code), Aider (terminal), Tabby (autocompletado). Configuraciones incluidas, listas para pegar.
4 · Programa
Refactoriza, explica, genera, depura — en tu repositorio, sin conexión, sin que una sola línea se envíe a la nube.
- El espacio en línea de por vida: 25 capítulos siempre actualizados (índice completo más arriba), comandos que puedes copiar con 1 clic
- La guía PDF (~173 páginas) + el pack de configuraciones, Modelfiles y 44 prompts para descargar
- La hoja de referencia + el capítulo de solución de problemas
- Todas las ediciones mensuales, de por vida: aparecen en tu espacio
- Acceso inmediato tras el pago; clave de acceso enviada por correo electrónico
Pago seguro mediante Stripe. Te llevas el PDF y las configuraciones en menos de un minuto. Factura PDF enviada automáticamente · TVA no applicable, art. 293 B du CGI.
La verdad sin adornos
Lo local sustituye ~90 % de tu uso de Copilot/Cursor — no el 100 %. Te decimos con franqueza dónde gana y dónde la nube conserva la ventaja. Una guía de referencia te debe esta visión honesta:
Al terminar el kit, sabrás hacer esto
- Elegir el modelo adecuado para TU máquina (y saber cuál evitar) en 10 segundos.
- Tener un chat + agente en VS Code (Cline) que lee tu repositorio, refactoriza y explica — en local.
- Un autocompletado que funciona (buenos tokens FIM, buen modelo), no uno que invente.
- Diagnosticar y reparar solo cuando falla (OOM, GPU, lentitud).
- Programar sin conexión, sin suscripción, sin que se envíe ni una sola línea de tu código a otro lugar.
Edición vivante — el registro de cambios público
«Actualizaciones de por vida» no es un eslogan: el kit sigue la evolución del ecosistema (adquisiciones, elementos declarados obsoletos, nuevos modelos) por ti. La prueba, con fecha:
v2026.10 (edición actual, 19/10/2026) — un nombre de modelo corregido (qwen3-coder:30b), las funciones en la nube de Ollama desactivadas, Open WebUI fijado en una versión concreta, artículo 4 de la AI Act actualizado.
v2026.09 — el kit se abre más allá del código (23 → 25 capítulos): tu ChatGPT privado (Open WebUI / AnythingLLM, RAG sobre tus documentos, prompts no relacionados con la programación) + la IA local en el trabajo (argumentario RGPD / Ley de IA + nota para la dirección de TI lista para enviar, plantilla incluida en el paquete).
v2026.08 — 6 módulos avanzados añadidos (17 → 23 capítulos): evaluar el rendimiento de tu máquina, flujo de trabajo multiproyecto, RAG sobre tu documentación, hook pre-commit local, endurecimiento de la seguridad, biblioteca de 44 prompts.
v2026.07 — pila tecnológica reorientada hacia Cline + Aider + Tabby/Twinny tras la integración de Continue.dev en Cursor · Modelfiles Qwen2.5-Coder / Qwen3-Coder / Devstral / DeepSeek-Coder reajustados · tokens FIM verificados byte a byte.
Muchos tutoriales gratuitos aún recomiendan Continue. Tú eliges una infraestructura de software con futuro, y cada edición mensual te llega sin tener que volver a pagar.
Preguntas frecuentes
¿Cómo sustituir GitHub Copilot por una IA local?
Instalas Ollama, descargas un modelo de código (por ejemplo, Qwen2.5-Coder) y luego conectas Cline en VS Code (o Aider en el terminal) a Ollama. El kit proporciona los pasos exactos + las configuraciones listas para pegar — calcula 30 minutos.
¿Qué IA local elegir para programar?
Según tu VRAM: Qwen2.5-Coder 7B (8 GB), 14B (12 GB), Devstral 24B (16 GB), 32B (24 GB). La hoja de referencia del kit te indica el modelo adecuado y el comando exacto para tu máquina.
¿Se puede usar realmente Ollama en VS Code?
Sí: la extensión Cline (chat + agente) para el razonamiento y el refactorizado, y Tabby o Twinny para el autocompletado. Las configuraciones exactas — y los tokens FIM adecuados — se proporcionan en el paquete.
¿Funciona sin conexión?
Sí. Una vez descargado el modelo, todo funciona sin conexión: chat, refactorización, generación y autocompletado; 100 % local.
¿Hay que ser desarrollador para seguir el kit?
No. El kit empieza desde cero: instalar Ollama, elegir el modelo adecuado para tu máquina, conectar tu editor; cada paso está guiado, con comandos para copiar y pegar. Si sabes instalar un programa y abrir un terminal, puedes seguirlo. Los módulos avanzados te esperan para después.
¿Y si mi máquina no basta?
El capítulo «¿Tu máquina es suficiente?» te lo dice en 5 minutos (niveles a partir de 8 GB de VRAM, incluido Apple Silicon). Si no es suficiente, lo sabrás antes de comprar, no después. ¿No estás seguro? compruébalo en 30 segundos con el configurador (gratis) →
¿Es adecuado para empresas y para el RGPD?
Esa es precisamente la ventaja: tu código nunca sale de tu máquina, nada se envía a terceros ni se utiliza para entrenar un modelo. El kit también distingue las licencias que puedes usar en el trabajo (Apache 2.0 / MIT) de las que debes evitar.
¿Es gratis?
El LLM funciona localmente: 0 €/mes, sin suscripción, sin límite de uso. El kit (guía + configuraciones + espacio en línea de por vida) es una compra única de 24 €.
¿Y si no funciona en mi máquina después de la compra?
Satisfecho o te devolvemos el dinero durante 30 días: basta con un correo electrónico, sin necesidad de justificarlo.
¿Cómo se entrega?
Acceso inmediato tras el pago: tu espacio en línea de por vida (lectura siempre actualizada, enlace personal enviado por correo) + el PDF y el zip de las configuraciones para descargar. Acceso y descargas permanentes — y si pierdes el correo, pides de nuevo tu enlace en 10 segundos.
¿Y si QuéLLM cierra algún día?
El PDF (~173 páginas) y el zip de configuraciones son tuyos, descargados en tu equipo — no dependen del sitio. El espacio en línea es una comodidad para leer, no una condición de acceso.
¿Qué diferencia hay con las guías del sitio?
Las guías del sitio explican cada componente por separado. El kit es EL método de referencia: los 25 capítulos en el orden correcto, las configuraciones probadas y mantenidas (Cline, Aider, Tabby, Modelfiles), la resolución completa de problemas y 8 módulos avanzados que no existen en ningún otro sitio: todo actualizado cada mes. Es el sistema completo para montar tu copiloto local, no una colección de artículos.
¿Qué alternativa gratuita hay a GitHub Copilot?
La alternativa gratuita más completa es un copiloto 100 % local: Ollama más la extensión Cline en VS Code, con un modelo como Qwen2.5-Coder. El LLM funciona en tu máquina, por lo que es gratuito y funciona sin conexión, sin suscripción mensual. El kit Copiloto Local detalla la instalación y las configuraciones listas para pegar para cada nivel de VRAM.
¿Cómo programar con una IA en local?
Programar con una IA local requiere tres elementos: Ollama para ejecutar el modelo, un modelo de código adaptado a tu VRAM (por ejemplo, Qwen2.5-Coder) y una extensión en tu editor como Cline o Aider para el agente y el autocompletado. El kit Copiloto Local reúne este proceso con los comandos y las configuraciones probadas.
¿Cline o Continue con Ollama?
El kit se basa en Cline y Aider. Continue anuncia que se ha unido a Cursor; su repositorio oficial indica que el proyecto ya no recibe mantenimiento activo y que el código sigue disponible en modo de solo lectura. Por tanto, esto no garantiza el mantenimiento futuro de la extensión. Fuentes: continue.dev y github.com/continuedev/continue, consultadas el 6 de octubre de 2026.
Monta tu copiloto local.
La guía de referencia, desde la primera descarga hasta el copiloto que responde en tu editor: privado, sin suscripción, en tu máquina. Hoy, no «algún día».
Obtener el kit — 24 €