MacBook Pro M5 Max 128 GB: las verdaderas mediciones en IA local (benchmark 2026)
Un MacBook Pro M5 Max con 40 núcleos de GPU y 128 GB de memoria unificada, un protocolo escrito de antemano, seis modelos y un documento de 16 689 tokens: estas son las primeras mediciones públicas en francés sobre el portátil más potente de Apple para IA local. Las mediciones las realizó Joël Ramat, consultor en ciberseguridad y GRC, en su propia máquina, a petición nuestra y siguiendo nuestro protocolo. Todas las cifras son los datos brutos de salida de Ollama, sin retoques.
¿Estás eligiendo un equipo? Nuestras opciones por presupuesto →
El MacBook Pro M5 Max disponible hoy: MacBook Pro M5 Max — 36 GB / 2 TB.
¿Por qué esta elección? Nuestra ficha completa sobre MacBook Pro M5 Max — 36 GB / 2 TB →
Comparar todas las opciones por presupuesto, de 800 a 3 500 € →
Cuando te desplazas: qué portátil elegir para la IA local →
Enlaces de afiliados — posible comisión sin coste adicional para ti. Como socio de Amazon, QuelLLM obtiene un beneficio de las compras que cumplen las condiciones requeridas.
#La máquina y el protocolo
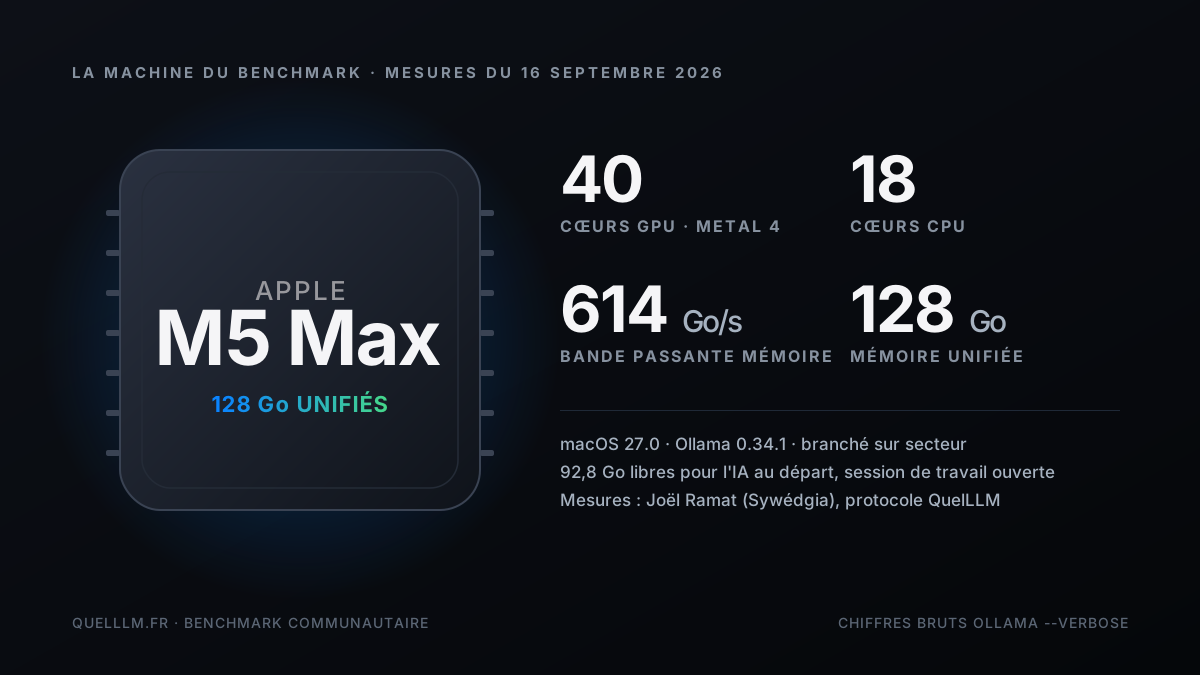
El equipo es un MacBook Pro de 16 pulgadas con el chip M5 Max completo: 18 núcleos de CPU, 40 núcleos de GPU y 128 GB de memoria unificada con un ancho de banda anunciado de 614 GB/s. Ejecuta macOS 27.0 con Ollama 0.34.1. No se ha modificado ningún parámetro del sistema: el límite de memoria de la GPU es el predeterminado, un dato importante para comparar con tu propio Mac.
El protocolo consta de cuatro reglas, y no son decorativas. Mac conectado a la red eléctrica, porque macOS limita el rendimiento del chip cuando funciona con batería. Aplicaciones pesadas cerradas. Solo un modelo cargado a la vez. Y, sobre todo, el mismo prompt para todas las series, el que hace que las cifras sean comparables entre modelos y, mañana, entre máquinas.
- Serie A, los dos puntos de referencia
- Gemma 4 12B y Qwen 3.8 27B en GGUF, dos modelos que también funcionan en Macs mucho más modestos. Colocan la máquina en una escala conocida.
- Serie B, MLX contra GGUF
- El mismo Qwen 3.8 27B, mismo peso, servido por el motor MLX de Ollama en lugar de llama.cpp. Solo cambia el motor.
- Serie C, lo que realmente importa al pasar a 128 GB
- gpt-oss 120B, 65 GB, un modelo que simplemente no cabe en un PC portátil.
- Serie D, el prefill en carga real
- Un documento de 16 689 tokens enviado en un solo bloque a gpt-oss 120B, con una instrucción de síntesis. Es el único registro de prelleno significativo de la campaña.
- Dos extras fuera del protocolo
- Joël ya tenía Qwen 3.6 35B-A3B en MLX y gpt-oss 20B en su máquina. Los midió bajo las mismas condiciones.
#Todos los números en una tabla
La IA local en tu Mac, a fondo: memoria unificada, MLX vs GGUF, el modelo adecuado para tu chip, Ollama y LM Studio configurados para Apple Silicon.
- Espacio en línea de por vida
- PDF + archivos
- Reembolsado 30 j
Aquí están las salidas sin procesar del comando ollama run --verbose, tal como Joël las copió después de cada medición. Cada modelo produjo una respuesta completa al prompt de 300 palabras, en modo de razonamiento cuando el modelo dispone de él, lo que explica los 1.400 a 3.200 tokens generados para 300 palabras de texto final.
| Modelo | Motor | Tamaño del modelo | Generación | Tokens generados | Duración total |
|---|---|---|---|---|---|
| Gemma 4 12B | GGUF Q4 | 7,6 GB | 58,1 tok/s | 1 390 | 24 s |
| Qwen 3.8 27B | GGUF Q4 | 17 GB | 36,6 tok/s | 2 517 | 69 s |
| Qwen 3.8 27B | MLX | 18 GB | 68,0 tok/s | 2 103 | 31 s |
| Qwen 3.6 35B-A3B (bonus) | MLX | 23 GB | 167,2 tok/s | 3 205 | 19 s |
| gpt-oss 20B (bonus) | MXFP4 | 13 GB | 113,4 tok/s | 2 199 | 19 s |
| gpt-oss 120B | MXFP4 | 65 GB | 79,1 tok/s | 669 | 8,5 s |
| gpt-oss 120B, repetición 1 | MXFP4 | 65 GB | 77,5 tok/s | 732 | 12,5 s |
| gpt-oss 120B, reinicia 2 | MXFP4 | 65 GB | 75,5 tok/s | 1 707 | 22,7 s |
| gpt-oss 120B, serie D | MXFP4 | 65 GB | 67,6 tok/s | 2 584 | 50 s |
| Serie | Tokens de prompt | Prefill | Tiempo hasta la primera palabra |
|---|---|---|---|
| A, B, C (prompt corto) | 43 à 98 | 31 a 346 tok/s | 0,1 a 0,9 s: latencia de inicio, no una tasa de generación |
| D, documento de 16 689 tokens | 16 689 | 1 388 tok/s | 12,0 s |
#Generación: seis modelos, una lectura
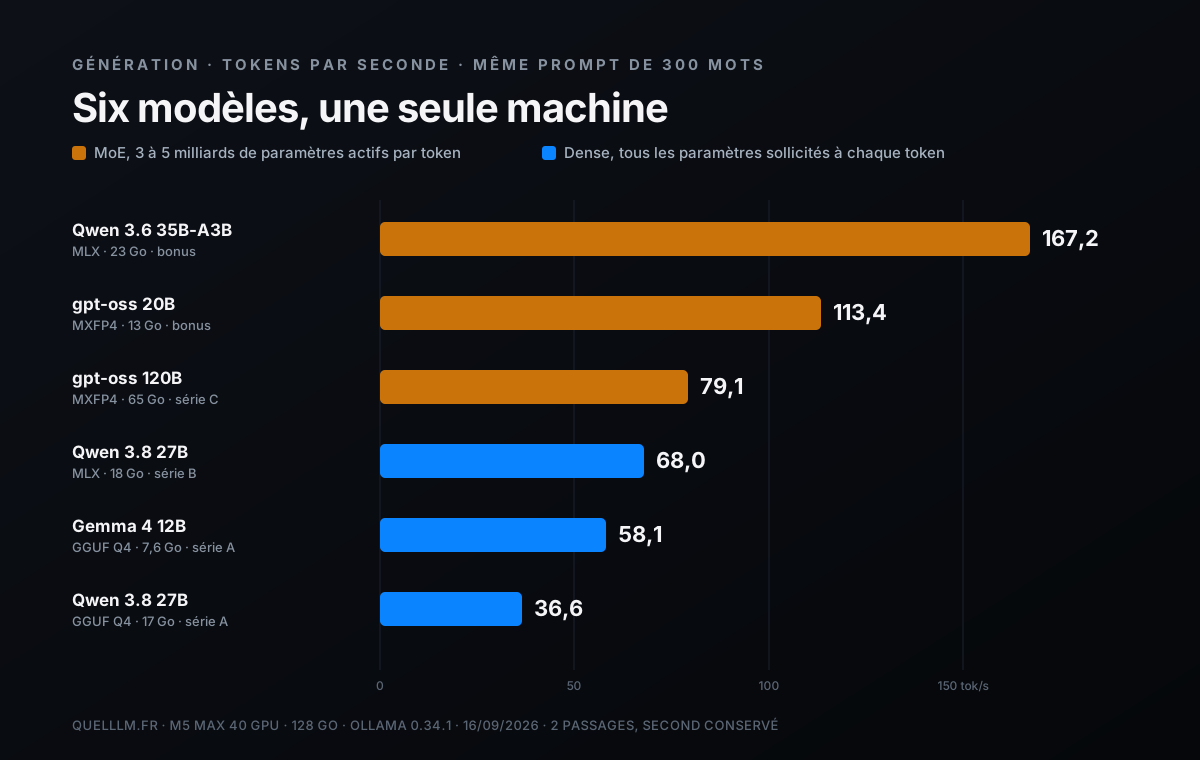
Si se interpreta de forma ingenua, esta clasificación es absurda: un modelo de 120 mil millones de parámetros a 79 tokens por segundo, dos veces más rápido que un 27B en GGUF. La explicación se reduce a tres letras. gpt-oss 120B, gpt-oss 20B y Qwen 3.6 35B-A3B son modelos de mezcla de expertos, MoE. Para cada token, solo una fracción de los parámetros se activa: aproximadamente 5 mil millones para gpt-oss 120B, 3,6 mil millones para gpt-oss 20B y 3 mil millones para el Qwen. La velocidad de generación depende de lo que se mueve en memoria en cada token, no de lo que está en reposo.
Los modelos densos, Gemma 4 12B y Qwen 3.8 27B, utilizan todos sus parámetros en cada token. Su velocidad viene determinada, por tanto, por el ancho de banda de la memoria dividido por el tamaño del modelo: es la regla de los Mac desde el M1, y el M5 Max tampoco escapa a ella. En esta máquina, un modelo denso de 27B en GGUF funciona a 37 tokens por segundo, y uno de 12B, a 58.
- 167 tok/s en Qwen 3.6 35B-A3B con MLX
- La cifra más alta de la campaña, obtenida con el modelo que combina los dos aceleradores: arquitectura MoE y motor MLX. Es la velocidad de un pequeño 8B, con los conocimientos de un 35B.
- 113 tok/s con gpt-oss 20B
- La mejor relación entre velocidad, calidad y peso para un uso diario de tipo asistente: 13 GB, una respuesta de 2.200 tokens en 19 segundos.
- 79 tok/s en gpt-oss 120B
- El modelo más capaz de la lista, al doble de la velocidad de lectura humana. Este es el resultado que justifica el nivel de 128 GB; volveremos sobre él más abajo.
- 58 y 37 tok/s en modelos densos
- Gemma 4 12B y Qwen 3.8 27B en GGUF: funcionan con holgura, pero sin sorpresas. Las cifras son del mismo orden de magnitud que en un M4 Max, ya que el ancho de banda ha cambiado poco entre las dos generaciones.
#MLX frente a GGUF, en igualdad de condiciones
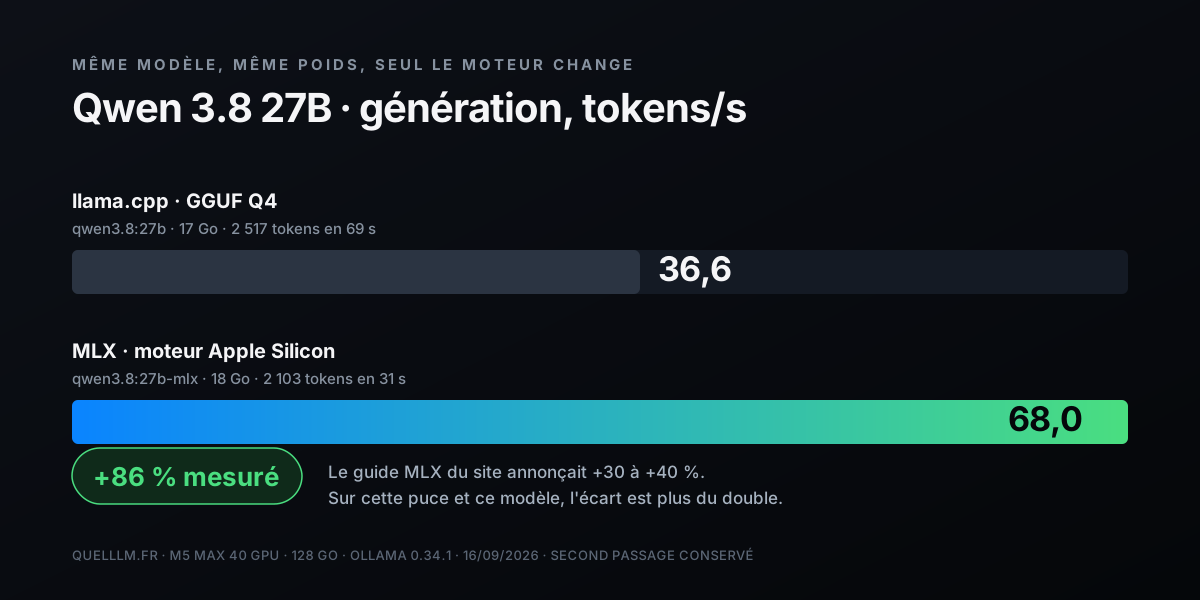
Todos dicen que MLX, la biblioteca de Apple optimizada para Apple Silicon, es más rápida que llama.cpp. Muy pocos lo comprueban mediante mediciones en condiciones estrictamente iguales, con el mismo modelo, el mismo día y en la misma máquina. Eso es lo que hace la serie B: Qwen 3.8 27B en GGUF Q4 a 36,6 tokens por segundo, luego Qwen 3.8 27B en MLX a 68,0 tokens por segundo. Un 86 % más.
Nuestra guía sobre MLX y el Mac M5 anunciaba una mejora del 30 al 40 % en generación. En el M5 Max y con este modelo, la realidad es más del doble. Parte de la diferencia se debe probablemente a las optimizaciones de MLX específicas de la generación M5 y a los aceleradores neuronales integrados en la GPU; aún no podemos aislar su contribución. Lo que sí podemos decir es que, en un Mac reciente, ejecutar un modelo denso en GGUF cuando existe su versión MLX equivale a dejar la mitad de la máquina en el garaje.
#Lo que realmente te ofrecen 128 GB
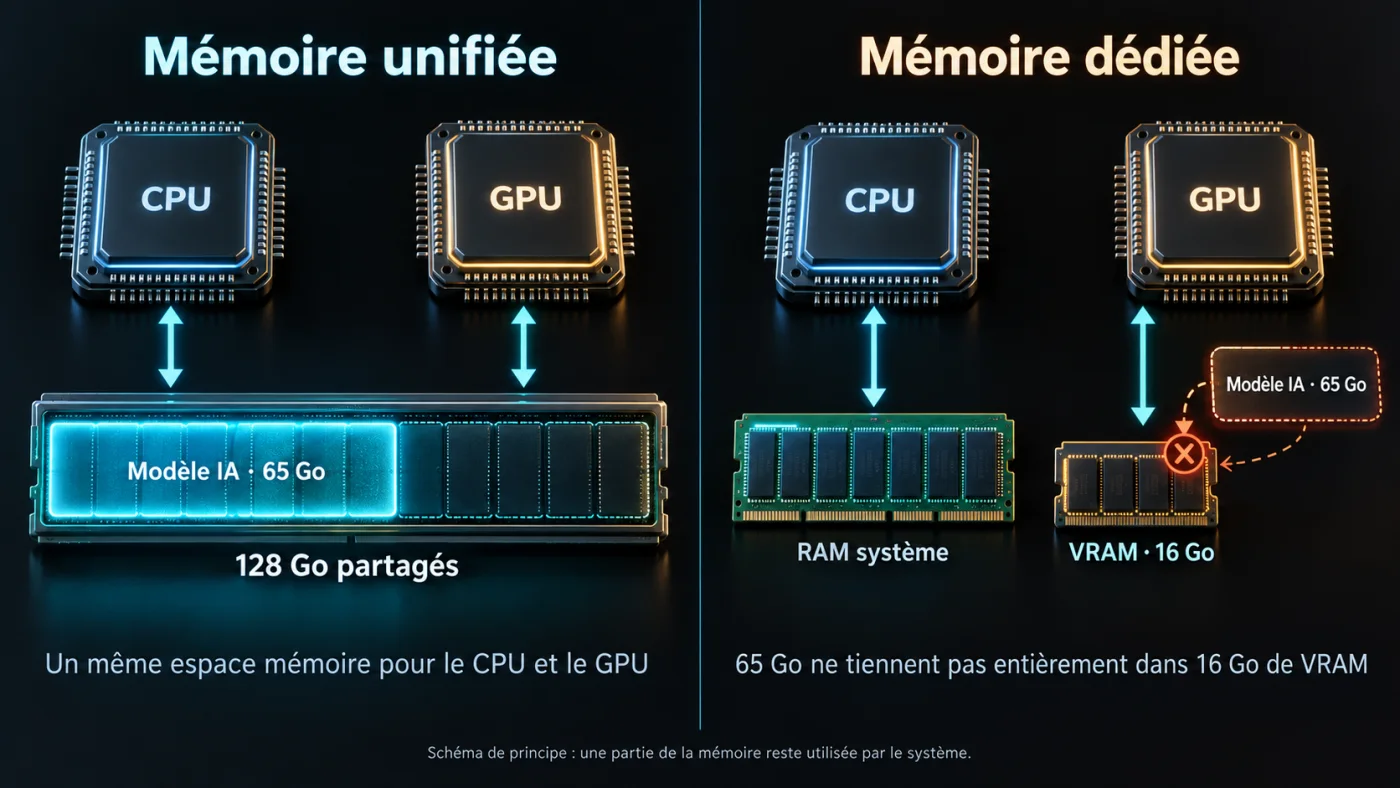
Lo que realmente importa en el nivel de 128 GB no es la velocidad, sino qué modelos caben. gpt-oss 120B ocupa 65 GB en MXFP4. Ningún PC portátil lo ejecuta en GPU: las tarjetas gráficas para portátiles tienen un límite de 16 o 24 GB de VRAM. En el M5 Max de 128 GB, se carga, responde a una velocidad de entre 75 y 79 tokens por segundo en tres ejecuciones y aún queda espacio.
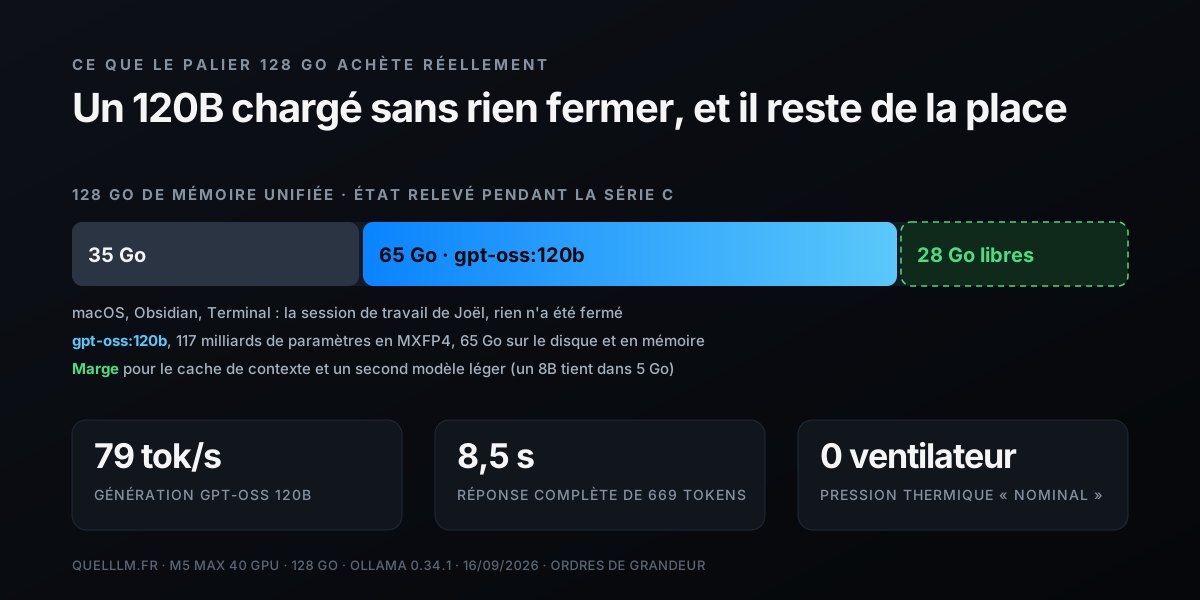
La medición de memoria realizada antes de la campaña es reveladora: 35 GB ocupados por macOS y las aplicaciones de la sesión de trabajo, 93 GB disponibles para la IA. El 120B cabe con un margen de unos treinta gigabytes, suficiente para mantener un contexto largo y un segundo modelo ligero en paralelo, por ejemplo un 8B para el autocompletado de código. En un M5 Max de 64 GB, el mismo modelo no se carga en absoluto; con 96 GB cabe, pero sin margen para el resto.
- 8,5 a 22,7 segundos
- Duración total de la respuesta de gpt-oss 120B al prompt de 300 palabras, en tres ejecuciones: 669, 732 y luego 1.707 tokens generados. La velocidad no cambia (79,1; 77,5 y 75,5 tokens por segundo); lo que varía de una ejecución a otra es la longitud del razonamiento, según si el modelo decide contar sus palabras una por una o no.
- 50 segundos
- Duración de la serie D: lectura de un documento de 16.689 tokens y posterior redacción de una síntesis de 2.584 tokens en diez viñetas.
- Presión térmica « Nominal »
- Registro tras cada serie. No se oyó ningún ventilador durante toda la campaña de pruebas, incluido el modelo de 120B.
#El prefill, el número que nadie publica
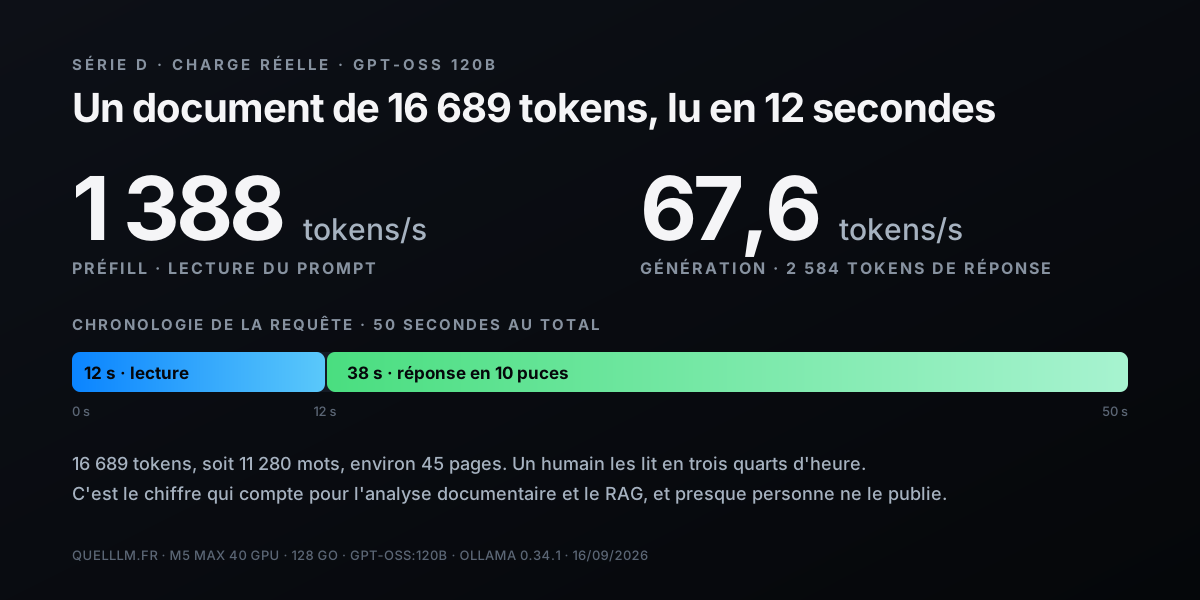
Un prompt de veinte palabras no dice nada sobre el prefill. Para medirlo, Joël envió a gpt-oss 120B un texto de 11.280 palabras en un solo bloque, equivalente a 16.689 tokens y unas 45 páginas, con una instrucción para resumirlo. Resultado: 1.388 tokens por segundo en lectura, es decir, doce segundos antes de que apareciera la primera palabra de la respuesta, y después 2.584 tokens de síntesis a 67,6 tokens por segundo.
Es la cifra relevante para los usos profesionales exigentes. Analizar un contrato, resumir un informe de auditoría, consultar una base documental mediante RAG: en todos estos casos, el modelo pasa la mayor parte de su tiempo leyendo, no escribiendo. Doce segundos para 45 páginas, en un portátil, sin que un solo byte salga de la máquina: eso es lo que hace que la IA local sea utilizable para un consultor sujeto al secreto profesional o una empresa con obligaciones de confidencialidad.
#Calor y ventiladores
Joël anotó el estado térmico después de cada serie con el comando de presión térmica de macOS. Veredicto constante: «Nominal», sin ventiladores audibles, incluso durante la serie D, que pone la GPU a plena carga durante cincuenta segundos. Es coherente con lo que observamos en los M4 Max, con una salvedad: nuestras mediciones son ráfagas de menos de un minuto. La prueba de throttling prevista en el protocolo —diez minutos de carga continua y después una nueva medición de la serie A— no se ha realizado. La solicitaremos en la próxima campaña.
#Lo que estas medidas no dicen
Un benchmark honesto lista lo que no demuestra. A continuación, las reservas en orden de importancia.
- Procesamiento inicial de prompts cortos (prefill)
- Dos ejecuciones por modelo; se conserva la segunda. Pero los prompts de 43 a 98 tokens solo permiten medir la latencia de inicio: únicamente la serie D, con 16 689 tokens, proporciona una tasa de lectura real.
- Ningún modelo denso de 70 mil millones
- El nivel de 128 GB también se justifica con los 70B en Q4 con un contexto largo. No medido aquí.
- Sin prueba de throttling
- Ráfagas de menos de un minuto. El comportamiento durante una hora de RAG intensivo aún queda por documentar.
- Sin mediciones con batería
- El protocolo exige conectar el equipo a la corriente. Con batería, espera cifras sensiblemente inferiores, ya que macOS limita el rendimiento del chip.
- Un documento de la serie D específico de cada evaluador
- El texto largo enviado en la serie D no viene fijado por el protocolo: dos evaluadores no leen el mismo documento, lo que limita la comparación del prefill entre máquinas. A sugerencia de Joël, el protocolo proporciona ahora un único texto de referencia de 11 292 palabras, que se puede descargar en la siguiente sección: las próximas mediciones serán comparables entre sí. La medición de esta página se realizó antes, con otro documento de tamaño equivalente.
- Una sola máquina, un solo operador
- No se ha medido la varianza. Si tienes la misma configuración, tus mediciones son bienvenidas; consulta la sección siguiente.
- Modelos en modo razonamiento
- Los modelos que piensan antes de responder generan muchos más tokens que las 300 palabras solicitadas, y esta longitud varía de una ejecución a otra para el mismo modelo (669 a 1.707 tokens en gpt-oss 120B). Por tanto, los tiempos totales no son comparables, solo las velocidades lo son.
- Caché de prompts al volver a ejecutarlos
- Cuando se vuelve a ejecutar el mismo prompt, Ollama reutiliza los tokens ya leídos (« prompt eval cached »). Por tanto, el prefill de una ejecución idéntica no sirve como medición; para medir el prefill, hace falta un prompt largo y nuevo, como en la serie D.
#Reproducir el benchmark en tu propio entorno
El protocolo está diseñado para reproducirse tal cual en cualquier Mac con Apple Silicon, desde el MacBook Air hasta el Mac Studio. Si sigues las mismas series con el mismo prompt, tus cifras son directamente comparables con las de esta página.
- 01Preparar la máquinaConecta el equipo a la corriente, cierra el navegador, Docker y las máquinas virtuales. Anota el modelo de tu chip, el número de núcleos GPU y la versión de Ollama.
- 02Registrar el estado del sistemaAnota el chip, el número de núcleos de GPU, las versiones de macOS y de Ollama, la alimentación eléctrica, la memoria disponible y las aplicaciones abiertas. Joël ha escrito un script zsh que genera este informe con un solo comando; se añadirá al capítulo de benchmarks del kit Mac tras su verificación, con su autorización.
- 03Serie ADescarga gemma4:12b y qwen3.8:27b, ejecuta cada uno con --verbose, pega el prompt común, deja que la respuesta termine y sal con /bye. Haz dos pasadas y conserva la segunda.
- 04Serie BHaz lo mismo con qwen3.8:27b-mlx. Compara la línea eval rate con la de la serie A.
- 05Serie CSi tienes 96 GB o más: gpt-oss:120b. De lo contrario, elige el modelo más grande que quepa en tu memoria unificada dejando 10 GB libres.
- 06Serie DDescarga el texto de referencia de QuelLLM, de 11 292 palabras, el mismo para todos, y pásalo a ollama run seguido de la instrucción « Resume este texto en 10 viñetas ». Anota el número de tokens del prompt que se muestra: depende del modelo, no del texto.
#Para quién, y a qué precio
El M5 Max de 128 GB se justifica por un único uso: ejecutar localmente modelos que no caben en ningún otro portátil, con margen para el contexto y un segundo modelo. Con gpt-oss 120B a 79 tokens por segundo y un documento de 45 páginas leído en doce segundos, sin ventilador, es una estación de trabajo de IA que cabe en una bolsa.
| Tú eres | Lo que te dice este benchmark | Nivel recomendado |
|---|---|---|
| Consultor, abogado o experto contable sujeto al secreto profesional | Un 120B lee y sintetiza tus documentos en local, a una velocidad que permite trabajar con él, sin enviar nada al exterior | M5 Max 128 GB |
| Desarrollador que quiere un copiloto local serio | gpt-oss 20B o Qwen 3.6 35B-A3B son más que suficientes y caben en 48 GB. Nuestros 113 y 167 tok/s corresponden al chip con 40 núcleos de GPU: la memoria es suficiente, pero la velocidad será inferior en una variante con menor ancho de banda | M5 Max 48 o 64 GB |
| Usuario que utiliza a diario un asistente de redacción | Un 12B denso o un MoE 20B cubren este uso; la configuración de 128 GB es un lujo. La memoria es suficiente, pero la del M5 Pro es más lenta: prevé velocidades inferiores a nuestros 58 y 113 tok/s. | M5 Pro 48 GB |
| Equipo que quiere un servidor compartido | El Mac Studio M5 Max o Ultra ofrece el mismo motor con más memoria y una refrigeración propia de un equipo de sobremesa | Mac Studio |
Si tus necesidades se limitan a modelos de hasta 30 mil millones de parámetros, basta con la mitad de la memoria y la diferencia de precio permite comprar una pantalla muy buena. Si tus necesidades empiezan en los modelos de 100 mil millones, no existe una alternativa portátil, y esta guía te da las cifras para justificarlo ante quien firma la orden de compra.
#Créditos y fuentes
Las mediciones de esta página fueron realizadas por Joël Ramat, consultor en ciberseguridad y GRC, experto en ISO 27001, que realiza consultoría y auditoría potenciadas por IA on-premise, cofundador y presidente de Sywédgia SAS. Ejecutó el protocolo QuelLLM en su propia máquina el 16 de septiembre de 2026 y revisó este artículo antes de su publicación. Los registros siguen siendo suyos y él es libre de publicarlos por su cuenta.
- Joël Ramat en LinkedIn
- Sywédgia, asesoramiento y auditoría de ciberseguridad
- Nuestra guía MLX frente a llama.cpp en Mac M5
- Hoja de especificaciones del equipo MacBook Pro M5 Max
- Instalar gpt-oss con Ollama
Método: salidas sin procesar de ollama run --verbose copiadas después de cada medición, sin modificaciones; estado del sistema registrado mediante un script antes de la campaña de mediciones; presión térmica registrada después de cada serie. El informe completo, con las respuestas íntegras de los modelos, se conserva y puede facilitarse previa solicitud. Redacción y formato: Mohamed Meguedmi, QuelLLM.fr.
#FAQ
¿El M5 Max de 128 GB es más rápido que el M4 Max de 128 GB en IA local?+
¿Por qué gpt-oss 120B es más rápido que Qwen 3.8 27B?+
¿Se necesitan 128 GB para ejecutar gpt-oss 120B?+
¿Estas cifras también se mantienen cuando funciona con batería?+
¿Por qué no se publican los prefills de las series A, B y C?+
¿Puedo enviar mis propias mediciones?+
¿Dónde encontrar el script de preparación utilizado para este benchmark?+
¿Un comentario, un error, una precisión? Avísanos, eso mejora la guía para todos.