Inicio › Reseñas y pruebas › GLM Coding Plan
GLM Coding Plan: nuestra opinión tras probarlo
Acceso mediante API a los modelos GLM, pensado para los asistentes de código — por el laboratorio que publica sus pesos como open weights.
La mejor relación calidad/precio del momento para conectar un asistente de código a un gran modelo — precisamente porque los pesos son abiertos y conservas una alternativa local. La salvedad es real: una parte de los suscriptores considera opacas las cuotas del plan.
¿Qué es, exactamente?
GLM es la familia de modelos del laboratorio chino Zhipu AI (marca internacional: Z.ai), cotizado en Hong Kong desde enero de 2026. Su particularidad, y la razón por la que este sitio lleva meses hablando de ella: los pesos se publican de forma abierta. GLM-5, GLM-5.1, GLM-5.2 figuran en nuestro catálogo, con sus requisitos de VRAM.
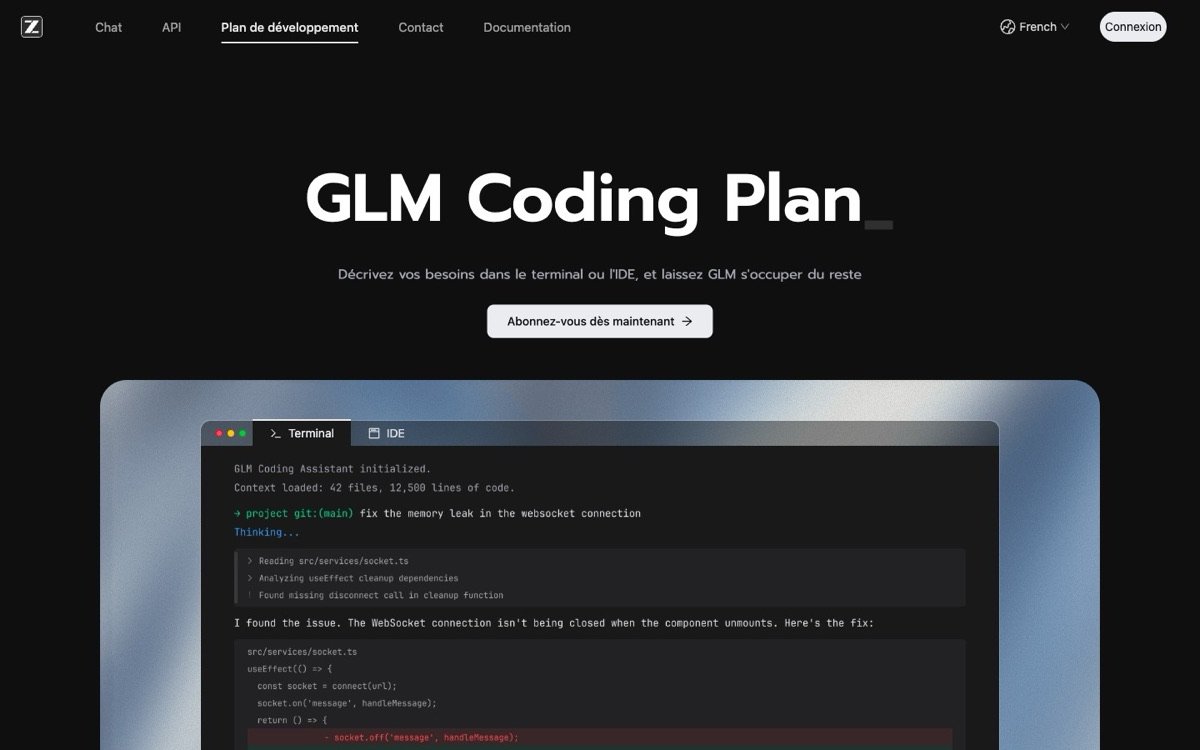
El Coding Plan es una suscripción a una API orientada al código: expone los modelos GLM a través de un protocolo compatible con los asistentes existentes (Claude Code, Cline, Roo Code), a un precio significativamente inferior al de las API equivalentes estadounidenses. La idea es simple: tu herramienta de código no nota la diferencia, pero tu factura sí.
Nuestra prueba: hasta dónde llega el GLM local en una GPU de consumo
Antes de evaluar la API, hemos llevado la opción local hasta su límite en nuestro equipo de pruebas (RTX 5070 Ti 12 GB + Intel Core Ultra 9 275HX, CachyOS, Ollama). Ese es precisamente el interés de una familia de modelos con pesos abiertos: la pregunta no es «API o nada», sino «a partir de qué momento se vuelve necesaria la API». Una respuesta basada en mediciones y respaldada por cifras:
| Medición (26/08/2026) | Resultado |
|---|---|
| Modelo probado localmente | GLM-4.7-flash (cuantizado q4) |
| Peso en memoria | 20 GB — para 12 GB de VRAM: transferencia de carga, 47 % CPU / 53 % GPU |
| Generación (tarea de código Python) | 35 tokens/s — sorprendentemente fluido |
| Procesamiento del prompt (prefill) | 5.8 tokens/s — el verdadero cuello de botella |
| Carga del modelo | 25 s |
La medición cuenta una historia más matizada que «no cabe»: incluso con la mitad del modelo descargada a la CPU, el modelo genera a 35 tokens/s — cómodo para chat. Pero el procesamiento del prompt llega a 5,8 tokens/s: enviar un archivo de 2.000 tokens a analizar ya lleva más de cinco minutos de silencio antes del primer token. Pero un asistente de código pasa su tiempo haciendo exactamente eso — revisar tus archivos en cada iteración.
Conclusión inequívoca: en una GPU de consumo de 12 GB, esta familia de modelos es inutilizable como agente de programación local, no por la generación sino por el prefill. Es precisamente el vacío que viene a cubrir el Plan de Codificación: la misma familia de modelos, servidos con un prefill instantáneo, mientras tu GPU sigue libre. Y si tienes 24 GB de VRAM o más, vuelve a hacer el cálculo — el configurador te lo da para tu máquina.
Precios
El Coding Plan está disponible en varios niveles (desde el plan básico para uso individual hasta el nivel «Max» para uso intensivo con múltiples agentes). Los precios observados en agosto de 2026 van desde unos pocos dólares al mes para el nivel básico hasta unas decenas para los niveles superiores, es decir, un orden de magnitud por debajo de las suscripciones equivalentes de Anthropic u OpenAI. Z.ai ofrece promociones frecuentes para el primer mes: revisa el precio actual antes de suscribirte, ya que cambia rápidamente.
Puntos fuertes y reservas
- Pesos abiertos = sin dependencia de un proveedor: tus prompts, tu flujo de trabajo e incluso el modelo siguen siendo recuperables en local
- Compatible con los asistentes de código existentes (Claude Code, Cline, Roo Code) sin necesidad de cambiar de herramienta
- Precio de entrada muy inferior al de las API estadounidenses equivalentes
- Empresa sólida: Zhipu AI, cotizada en Hong Kong, uno de los principales laboratorios de modelos abiertos
- Cuotas que algunos suscriptores consideran opacas («3× Claude» cuestionado en horas punta) — Trustpilot 2,1/5 con 32 reseñas en agosto de 2026, vigila tu consumo durante la primera semana
- Atención al cliente lenta según los mismos comentarios
- Tus consultas pasan por los servidores de Z.ai: una opción que debes descartar para código sujeto a un NDA — esto se aplica a cualquier API, y por eso la ejecución local sigue siendo nuestra referencia
Preguntas frecuentes
¿Se puede usar GLM de forma gratuita?
Sí. Los modelos GLM se publican con pesos abiertos: las variantes cuantizadas se descargan y ejecutan gratis con Ollama o LM Studio, siempre que tengas suficiente VRAM. La suscripción solo cubre el acceso a API de las variantes completas, servidas en la infraestructura de Z.ai.
¿Funciona GLM Coding Plan con Claude Code?
Sí, ese es su argumento principal: la API expone un protocolo compatible, basta con apuntar la herramienta al endpoint de Z.ai. Cline y Roo Code también están soportados. La configuración tarda unos minutos.
¿Son fiables los límites anunciados?
Es la principal objeción documentada. Algunos suscriptores señalan que la cuota se consume más rápido de lo anunciado en las horas punta, y eso repercute en la puntuación del servicio en Trustpilot (2,1/5 en una pequeña muestra de 32 reseñas). Nuestro consejo: empieza por el nivel básico, mide una semana de uso real y luego decide.
¿Dónde van mis datos con este plan?
Tus solicitudes se procesan en los servidores de Z.ai. Para código propietario sujeto a un NDA o datos regulados, la regla no cambia: sigue usando un modelo local; precisamente esta familia lo permite, ya que sus pesos son abiertos.
¿Qué máquina se necesita para ejecutar GLM localmente?
Las pequeñas variantes cuantizadas se ejecutan en un GPU de 8 a 12 GB. Las variantes MoE recientes (GLM-4.7-flash: ~20 GB cargado en q4, medido en nuestra máquina) requieren más — esto es medible en nuestro configurador, que te dice exactamente qué puede soportar tu máquina.
Las otras reseñas de la selección
Transcripción, subtítulos y traducción por IA, con revisión humana opcional — la empresa europea mejor valorada de nuestra selección.
Leer la reseña →Transformar una conversación en un agente reutilizable, conectado a tus herramientas — sin escribir código.
Leer la reseña →Bootcamps en línea — data science & IA, ciberseguridad, UX y desarrollo web — con acreditación de calidad alemana.
Leer la reseña →Transparencia. El enlace «Ver GLM Coding Plan» es un enlace de afiliación (plataforma Impact.com). En caso de suscripción, QuelLLM.fr recibe una comisión pagada por la marca, sin costo adicional para ti. Esta comisión no influye en la calificación ni en el contenido: la alternativa local gratuita se menciona antes del enlace de compra, y las objeciones recogidas en las opiniones de los clientes se publican tal cual. Metodología completa · Aviso legal.